开发日志(五):关卡扩展、视觉统一与共享逻辑重构
一、目标驱动的关卡
此前,DarkForest 的主要目标是让角色在随机地图中探索、收集装备、遭遇敌人,并最终决出幸存者。这个玩法足以验证移动、探索、战斗和 NPC 决策,但长期只使用“最后幸存者”作为胜利条件,会让许多行为退化为同一种优化目标:尽量活到最后。本阶段引入另一种对局结构——“圣物归家”,让玩家除了应对生存风险,还必须完成探索、夺取目标和返程。
本次新增了 LevelKind、VictoryCondition 与 LevelDefinition,并通过 LevelCatalog 保存关卡定义。LastSurvivor 要求成为最终幸存者;RelicReturn 则要求角色探索中央圣物房间、选择一项能力增强,并携带圣物返回自己的出生房间。关卡类型负责声明目标,具体是否结束对局仍由 GameController 结合当前状态判定。
RoomKind 增加了巢穴与圣物等类型,NPC 和怪物的行为也开始围绕这些特殊地块调整。例如,角色携带圣物后会优先考虑返乡,其他角色可依据个人记事本中的圣物线索调整路线;守卫则受特殊区域的移动约束。这些机制使地图不再只是随机移动的容器,而开始承担关卡目标的空间结构。
三、视觉效果改进
1. 整体视觉效果
这一轮另一项重要工作,是让游戏界面从默认控件风格暂时替换成具有意义的、可预览的视觉语言。纸张、旧金属、暗色背景与黄铜色文字被用于不同层级的面板,意在表现一种粗粝、危险但仍可阅读的探索氛围。与其在每个按钮上重复设置边框、颜色和悬停效果,新增了 HunterGearStyle,统一提供面板、按钮、选项框、标签页、输入框和文件对话框的样式;HunterGearDecoration 则负责绘制纸张或金属表面的装饰,让材质表现与具体布局分离。
后续提交进一步引入字体资源和 Godot 的 Theme 文件,使标题、按钮及面板文字的视觉关系更统一。这里的设计目标并不是让每个组件尽可能复杂,而是把风格管理从业务界面中抽出来:当整体色彩或按钮形态需要修改时,应尽量在一处完成,而不是逐个排查 MainUi 和场景文件。
2. 重要事件的独立视觉表达
战斗、探索和地图线索中的一些关键事件被分离成专门的表现模块。EncounterVisualLayer 负责房间内的遭遇提示,并根据对手是否被识别决定展示什么信息;这点很重要,因为视觉层不应因为拿到了内部角色对象,就直接泄露游戏规则尚未允许玩家知道的身份。GunshotMapEffect 根据枪声事件生成短暂的地图波纹,而持续若干回合的听觉线索仍然由游戏逻辑另行管理。瞬时动画与持续的规则影响因此不会混为一谈。NestSpawnSmokeLayer 在探索巢穴并实际释放怪物时播放烟雾效果。
3. 塔罗牌的有限三维旋转与 CPU—GPU 协同渲染
本次更新,我试验了将探索获得物品使用塔罗牌抽取的形式进行展示,这样或许可以使玩家更有沉浸感。同时,为了增加一点趣味性,也为了试验一下技术是否可行,我还为塔罗牌展示增加了有限三维旋转效果:当游戏界面展现塔罗牌时,点击则执行一次完整的正反面切换;玩家还可以通过鼠标拖拽使卡牌在有限角度内倾斜。
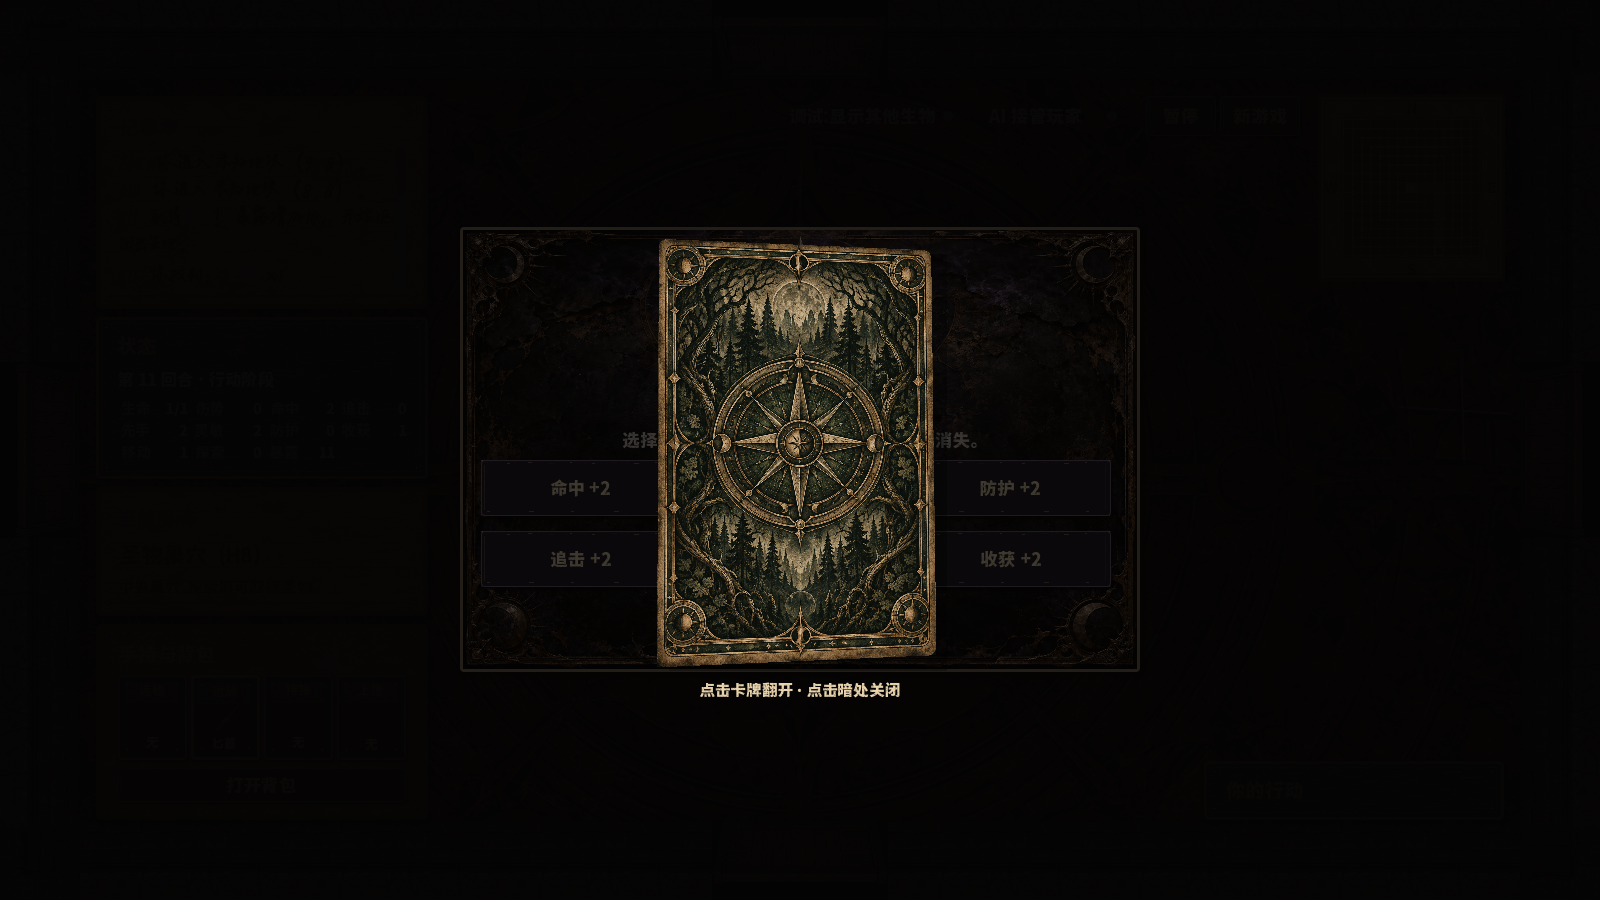
要实现这个功能,有一种比较省事的实现方式:创建一个真实的 3D 对象和空间,把正反面贴在同一个 3D 平面(Quad)上,绕固定中心旋转;相机固定,投影整张牌;拖动只旋转卡牌,而相机不动。最后,视口中显示相机所观察到的牌面。不过,我认为在这样一个 2D 游戏里,通过真实 3D 来实现这个功能,未免有点“德不配位”,并且还会产生一定的不必要的开销。因此我决定直接在 C# 中计算投影来获得相同的效果。
Table 1: 两种方案的渲染开销对比。各独立运行 3 次,每场景共采样 2160 帧。
| 场景 | 优化三视口 | 矩阵 2D 着色 | 减少百分比 |
| 静止,整帧耗时 | 0.3781 ms | 0.2974 ms | |
| 拖动,整帧耗时 | 0.3847 ms | 0.3327 ms | |
| 可见卡牌,渲染 GPU | 0.0860 ms | 0.0640 ms |
塔罗牌的呈现保留 Godot 的二维 Control 界面,使用 TextureRect、SubViewport 与 canvas_item Shader 实现具有透视深度的卡牌。这里需要区分两类动画:拖动鼠标时只允许卡牌在有限角度内倾斜,点击时则执行一次完整的正反面切换。前者是玩家可以随时控制的空间反馈,后者用于揭示已经由游戏规则确定的道具;两者共享同一套旋转与投影代码。
有限倾斜首先在 CPU 端处理。_GuiInput() 将鼠标位移 限制在长度不超过 的圆盘内,并将目标角度设置为
因此倾斜角向量的长度不超过 弧度,约为 度,避免鼠标拖拽造成卡牌无限旋转。_Process() 再使用系数 对当前角度和目标角度进行线性插值;这个与帧间隔 相关的指数形式,让手感不像直接赋值那样生硬,也比固定每帧插值比例更不依赖帧率。松开鼠标时目标角度回到零,卡牌会自然复位。
点击翻牌则使用持续 秒的独立进度 ,经过平滑函数
控制绕竖直轴的旋转。卡牌旋到侧面时,正面纹理才替换背面纹理;代码还在后半程为旋转角追加 ,使显示正面时文字朝向正确。严格来说,这不是直接连续旋转单张双面三维网格,而是在卡牌投影宽度接近零的时刻切换材质和角度分支,从视觉上模拟翻面。接近侧面时会发生投影退化,因此 CardRotation() 对 的角度进行微小避让,防止卡牌瞬间塌缩为不可逆的直线。
数学上的核心是透视投影与平面单应性变换。对卡牌纹理坐标 ,先构造位于局部平面的点 ,再按顺序施加绕竖直轴、水平轴以及翻牌轴的旋转矩阵,得到三维坐标 。取相机距离 ,视场角 ,以及投影参考尺寸 、,则归一化屏幕坐标满足
因为所有卡牌点都处于同一个平面,投影可以整理为一个 的单应性矩阵 ,使纹理坐标与屏幕坐标满足齐次关系 。反向采样时,设 ,便得到 、。CPU 每次更新角度时构造 ,并由 TryInvertHomography() 以双精度中间计算求出逆矩阵;当行列式过小时拒绝使用该变换。随后,CPU 只需把 的三行以及透明度发送给 ShaderMaterial。GPU 的片元着色器对每一个显示像素执行反向映射:先通过逆矩阵找回原始卡牌纹理的 ,再进行纹理采样;落在卡牌区域以外的片元直接丢弃。这样的反向采样避免了正向投影可能产生的纹理空洞,也将逐像素的重复工作交给图形渲染流水线。
为减少不必要的重绘,TarotCardArtwork 只在物品变化时组织卡面文字、数量与图集插画,并交给尺寸为 的 SubViewport 生成面纹。RenderTargetUpdateMode.Once 允许卡面按需刷新;此后拖动和翻转主要复用既有纹理、更新投影矩阵与 Shader 参数。待动画停止且倾角收敛时,SetProcess(false) 停止持续更新。由此形成了明确的软硬件分工:CPU 负责交互和少量几何运算,GPU 负责离屏纹理绘制及逐片元采样,游戏逻辑只负责确定获得了什么物品。
Figure 2: 塔罗牌展示的软硬件协同
五、将控制核心收回 Logic
在视觉系统扩展的同时,我也调整了项目组织。过去 GameController 虽然主要负责规则调度,却放在 Game 目录中;ActorState 和 PollingGameSession 也混杂在同一个控制文件里。对于仅有 Godot 前端的项目,这种安排尚可接受,但当独立模拟器和测试项目都要运行同一套对局时,目录与命名空间会直接影响依赖边界。因此将 GameController、MonsterController 等调整到 Logic,并把 ActorState、PollingGameSession 拆分为独立文件。早期的 GameSession 与已不再使用的旧迷宫生成实现也被移除。这样,Simulation 只需编译共享逻辑和必要工具代码,而 Godot 的 MainUi、地图绘制和动画继续留在表现层。
如下结构显示,Godot 前端和独立模拟程序不再各自维护一套规则。它们均调用共享的逻辑层;事件记录又可供回放和统计复用。
Figure 3: 项目的组织结构
行为记录同样得到补强。ActionJournal 除了按事件保存状态与决策,还增加检查点能力:Checkpoint(...) 在导出的副本末尾补充暂时性的结束记录,却不关闭正在运行的日志;Save(...) 使用临时文件写入再替换目标文件,降低意外中断产生残缺 JSON 的风险。这样,普通游玩过程也可以持续保存可回放进度,而无需必须等到整局结束。
六、验证工作与接下来的问题
回顾该版本,表面上最容易注意到的是字体、材质、卡牌和特效,但更深层的变化在于:关卡定义开始独立于通用规则,实验参数和统计口径有了统一入口,视觉模块消费逻辑事件,模拟器与游戏前端逐渐共用唯一的控制核心。下一步继续减少 GameController 的职责堆积,将关卡事件、战斗推进与观察生成拆成更明确的服务;另一方面,为将来可能接入强化学习,需要在现有 IAgentPolicy、AgentObservation 和合法动作检查之上,进一步定义奖励、终止条件以及按智能体决策划分的 reset/step 环境接口。这些仍是后续计划。
七、未来强化学习的马尔可夫状态转移视角
当前代码已提供 AgentObservation、AgentAction、IAgentPolicy 与 SimulationRunner.Run(settings, policy),但尚未实现奖励函数与标准化训练接口。考虑到游戏包含隐藏角色、未知房间和个人记事本,智能体只能看到局部观测,后续训练更接近部分可观察马尔可夫决策过程(POMDP)。完整世界状态仍应包含地图、角色、装备、轮询位置、战斗信息及关卡目标等影响未来转移的变量。
下面的图是完整环境状态按行为模式划分的抽象转移图。普通行动后可以继续行动,遭遇可能持续多轮,战斗结束可以重新行动;胜负条件触发后才进入终止态。
Figure 4: 按行为模式划分的抽象转移图
图中每条边是否可用以及实际转移概率,都依赖具体完整状态和所选合法动作,而不是固定常数。若以智能体决策作为时间步,则概率核可写为 ;策略则作用于由 Observe() 构造的 ,即 。未来还需要单独实现奖励 、终止信号及决策步 step()。