顺序表与链表,栈与队列
 Illustrated by
线性表(linear list)在逻辑上看似只是“把元素排成一排”,但“一排”只说明元素之间的逻辑关系,并没有规定元素在内存中应当怎样放置。如果从内存的角度观察,我们既可以把它们依次放进一段连续内存得到顺序表;也可以让每个元素各自占据一块内存、再用指针连接前后关系,得到链表。而从访问方式的角度来看,还可以限制数据只能从某一端输入与访问,于是得到栈;或者规定数据从一端进入、另一端离开,于是得到队列。
一、顺序表
顺序表是线性表的一种存储实现:逻辑上相邻的元素,在物理内存中也相邻。假如第一个元素地址为 ,每个元素占据 字节,那么第 个元素的地址就是 。正因地址能由一次乘加直接算出,按下标访问不需要从头遍历,复杂度为 。
长度在编译期固定时,可以使用数组 [T; N],其中 T 是元素类型,N 是数组长度。然而实际程序往往无法预先知道元素数,因此更常用可增长数组 Vec<T>。一个 Vec 的值本身只保存三个字段:ptr 指向堆上的缓冲区,len 表示其中已经初始化的元素数,capacity 表示当前缓冲区最多容纳多少个元素。必须区分后两者:0..len 区间对应的内存已经存入数据,可以被当作元素读取;len..capacity 区间对应的内存已经申请,却还没有放入有效的 T,不能被当作元素读取。
len 只统计已初始化元素;容量耗尽后,向量申请更大的缓冲区并移动已有元素。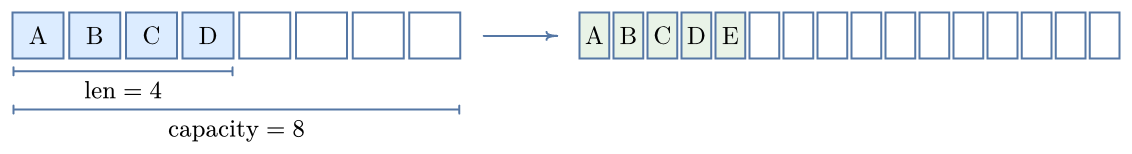
push 的总搬运量是几何级数 ,故单次 push 的摊还复杂度为 。若对一个 Vec 进行 push 操作、发现 len == capacity 时,向量需要申请更大的缓冲区,并把旧元素移动过去。这里说“移动”而不是“复制”十分重要:T 可以是 String、文件句柄或其他不能随意复制的值,Rust 只转移它们的所有权,不会凭空制造第二份资源。扩容完成后,旧缓冲区被释放,原先指向其中元素的引用也就不再有效;借用检查器因此不允许我们在持有 &vec[i] 时再调用可能扩容的 push。
下面的实现刻意把底层内存管理交给 Vec<T>,只实现“顺序表”这一层语义。这样既能看到接口和复杂度,也不会把主题淹没在分配器、对齐与 MaybeUninit<T> 等底层细节中:
#[derive(Debug, Default)]
pub struct SeqList<T> { data: Vec<T> }

impl<T> SeqList<T> {
    pub fn new() -> Self { Self { data: Vec::new() } }
    pub fn with_capacity(n: usize) -> Self {
        Self { data: Vec::with_capacity(n) }
    }
    pub fn len(&self) -> usize { self.data.len() }
    pub fn get(&self, i: usize) -> Option<&T> { self.data.get(i) }
    pub fn get_mut(&mut self, i: usize) -> Option<&mut T> { self.data.get_mut(i) }
    pub fn push(&mut self, value: T) { self.data.push(value); }
    pub fn insert(&mut self, i: usize, value: T) -> Result<(), T> {
        if i > self.len() { return Err(value); }
        self.data.insert(i, value); Ok(())
    }
    pub fn remove(&mut self, i: usize) -> Option<T> {
        (i < self.len()).then(|| self.data.remove(i))
    }
}
get 返回 Option<&T> 而不是直接索引,使“可能越界”成为返回类型的一部分,因此调用者必须手动处理可能获得 None 的情况。get_mut(&mut self) 的完整类型可以写成 fn get_mut<'a>(&'a mut self, ...) -> Option<&'a mut T>:返回引用的生命周期来自对顺序表的借用,不可能比顺序表本身活得更久。在这个可变引用存活期间,调用者也不能再次借用整个表去执行插入或删除。插入可能扩容,删除会搬移元素,若允许这些行为发生,旧引用就可能立即悬空或指向另一个元素。
当用户希望中间插入时,Vec::insert(i, value) 会把区间 [i, len) 整体向后移动一个槽位;删除时则把 (i, len) 向前移动。两者都必须特别处理 i == len、空表以及越界位置。若只关心快速删除而不要求保持顺序,可以使用 swap_remove:它把最后一个元素移到删除位置,从而把 降为 ,代价是改变元素次序。11 这个例子说明复杂度不是脱离接口的标签——“删除”究竟需不需要保持相对次序,直接决定可用的算法。
总结时间复杂度,顺序表按下标访问为 ;尾部追加摊还 ;中间插入、删除要移动后缀,均为 。然而该复杂度只统计操作次数,而不考虑现代处理器的强大缓存机制。连续内存允许硬件预取器提前加载后续元素,也使一次缓存行能够带回多个值;所以即使在理论上中间插入、删除的操作对顺序表而言需要移动若干元素,它在真实机器上的运行效率仍有可能胜过只需改几个指针的链表。
二、链表
顺序表在逻辑上与物理上,节点都是相邻的,而链表仅仅保留了逻辑相邻。链表的每个节点都分散在堆上。节点除保存元素外,还需要保存指向其他节点的指针。因此链表需要付出额外内存空间。例如,单链表每个节点多存储一个指针,双链表多两个。
1. 单链表、双链表与循环链表
a. 单链表
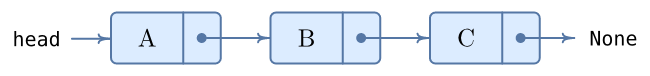
单链表的节点只保存一个后继指针。链表由首指针 head 进入;从首节点反复读取 next,就能按逻辑次序访问全部元素;末节点的 next 为空。因为节点不知道自己的前驱,所以在只持有当前节点时无法向前移动。头部插入和删除只改动 head 与一个 next,均为 ;尾部插入若没有额外保存尾指针,则必须先走到链尾,仍为 。
type Link<T> = Option<Box<Node<T>>>;
struct Node<T> { elem: T, next: Link<T> }

pub struct SinglyList<T> { head: Link<T>, len: usize }
impl<T> SinglyList<T> {
    pub fn new() -> Self { Self { head: None, len: 0 } }
    pub fn push_front(&mut self, elem: T) {
        let next = self.head.take();
        self.head = Some(Box::new(Node { elem, next }));
        self.len += 1;
    }
    pub fn pop_front(&mut self) -> Option<T> {
        self.head.take().map(|node| {
            self.head = node.next; self.len -= 1; node.elem
        })
    }
    pub fn iter(&self) -> impl Iterator<Item = &T> {
        std::iter::successors(self.head.as_deref(), |n| n.next.as_deref())
            .map(|n| &n.elem)
    }
}Box<Node<T>> 表示节点独占后继,Option 表示后继是否存在。push_front 不能直接写 next: self.head,因为那会从借用的 self 中移出字段;take() 先用 None 占住原位置,再把旧链头作为完整值移出。pop_front 反向转移所有权:取得旧首节点后,把它拥有的后继交还给链表。
这种所有权关系是一棵退化的树,不需要引用计数。默认析构会沿 Box 链递归进行;若链表可能极长,可以实现迭代式 Drop,循环 take 后继,避免析构过程占用过深的调用栈。
b. 双链表
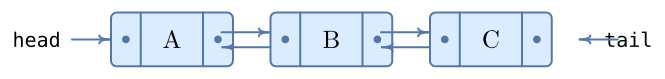
双链表的节点同时保存前驱 prev 与后继 next。它可以从首节点向后遍历,也可以从尾节点向前遍历;已知某个节点时,可以直接取得左右邻居。因此,在已持有目标节点的前提下,节点前后插入与删除都只需改动常数条连接。代价是每个节点多保存一个指针,而且每次修改都必须同时维护两个方向,边界情况也比单链表更多。
use std::{cell::RefCell, rc::{Rc, Weak}};
type Strong<T> = Option<Rc<RefCell<DNode<T>>>>;
type WeakLink<T> = Option<Weak<RefCell<DNode<T>>>>;
struct DNode<T> { elem: T, prev: WeakLink<T>, next: Strong<T> }
pub struct DoublyList<T> { head: Strong<T>, tail: Strong<T>, len: usize }

impl<T> DoublyList<T> {
    pub fn push_back(&mut self, elem: T) {
        let node = Rc::new(RefCell::new(DNode { elem, prev: None, next: None }));
        match self.tail.take() {
            None => self.head = Some(node.clone()),
            Some(old) => {
                node.borrow_mut().prev = Some(Rc::downgrade(&old));
                old.borrow_mut().next = Some(node.clone());
            }
        }
        self.tail = Some(node); self.len += 1;
    }
}若 prev 与 next 都使用 Rc 强引用,相邻节点会互相维持引用计数,链表释放后节点仍无法销毁。因此示例让 next 使用 Rc,而 prev 使用不增加强计数的 Weak。由于 Rc<T> 只能直接提供共享引用,节点内部再套 RefCell,把“多读或一写”的检查移到运行期;重叠的 borrow_mut() 会导致 panic。
这种写法适合讲清关系,但有引用计数和动态借用成本。标准库可以把裸指针与必要的 unsafe 封装在私有实现中,再以安全接口维护首尾、长度和相邻连接的不变量。
c. 循环链表
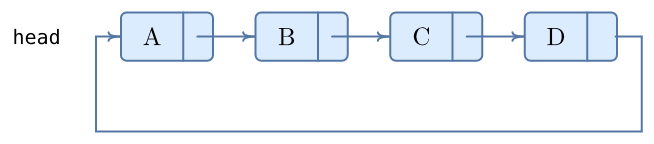
循环链表把尾节点的后继重新指向首节点,因此从任意节点不断前进都会周期性回到原处。它没有空指针作为天然终点,遍历必须以元素个数、哨兵节点或“是否再次到达起点”为停止条件。轮转调度、循环播放与约瑟夫环都能直接利用这种周期结构。
struct CNode<T> { elem: T, next: usize }
pub struct CircularList<T> {
    nodes: Vec<CNode<T>>,
    head: Option<usize>,
    tail: Option<usize>,
}

impl<T> CircularList<T> {
    pub fn new() -> Self {
        Self { nodes: Vec::new(), head: None, tail: None }
    }
    pub fn push_back(&mut self, elem: T) {
        let i = self.nodes.len();
        match (self.head, self.tail) {
            (None, None) => {
                self.nodes.push(CNode { elem, next: i }); // 自己构成一圈
                self.head = Some(i);
                self.tail = Some(i);
            }
            (Some(head), Some(tail)) => {
                self.nodes.push(CNode { elem, next: head });
                self.nodes[tail].next = i;
                self.tail = Some(i);
            }
            _ => unreachable!("head 与 tail 必须同时为空或非空"),
        }
    }
    pub fn values(&self) -> Vec<&T> {
        let mut out = Vec::with_capacity(self.nodes.len());
        if let Some(mut i) = self.head {
            for _ in 0..self.nodes.len() { // 不能等到 next == None
                out.push(&self.nodes[i].elem);
                i = self.nodes[i].next;
            }
        }
        out
    }
}Rc 把尾节点连回首节点,强引用环不会自然释放,至少一条边必须改用 Weak。示例改用 Vec 保存节点、以 usize 充当指针,这样没有引用环,也便于序列化。若进一步支持删除并复用槽位,应加入空闲链表与“代际索引”,防止旧索引误指后来放入同一槽的新对象。2. 增删查改
以下都以双链表为语义模型。增删查改绝不仅仅只是修改几个指针那么简单,更关键的是一系列的边界条件。例如,空表的 head 与 tail 同时为空;非空表从 head 沿 next 恰好访问 len 个节点并到达 tail;首节点没有前驱,尾节点没有后继;任一相邻节点 a、b 同时满足 a.next == b 与 b.prev == a。
a. 节点的遍历与查找
从头或尾沿指针遍历需要 。已知位置 时,若 就从首节点向后走 步,否则从尾节点向前走 步,使实际步数降为 。按值查找仍需逐节点比较,最坏访问全部节点;若链表有序,可以在超过目标后提前结束,却仍不能像数组那样直接二分到中点。
fn node_at<T>(list: &DoublyList<T>, i: usize) -> Strong<T> {
    if i >= list.len { return None; }
    let mut cur = list.head.clone();
    for _ in 0..i { cur = cur?.borrow().next.clone(); }
    cur
}Rc 句柄,这会把节点共享所有权暴露给调用者;即使节点已从链表摘下,外部仍可能让它继续存活。生产接口若只需读取元素,更适合返回受链表生命周期约束的借用、让闭包在借用期间完成操作,或在 T: Clone 时返回值副本。b. 节点的插入与删除
插入 x 到 left 与 right 之间时,先保存两侧节点,再建立 x.prev=left 与 x.next=right,最后令 left.next=x、right.prev=x。这个次序保证中途始终保存着原后半段链表。若 left 不存在,x 成为新首节点;若 right 不存在,x 成为新尾节点;空表插入时,首尾同时指向唯一节点。
删除节点 x 时先保存其左右邻居,再令两邻居跨过 x 互相连接,最后清空 x 自身的连接。删除唯一节点会同时清空首尾;删除首节点只存在右邻居,删除尾节点只存在左邻居。完成结构更新之后再把长度减一,可使每条成功路径只修改一次计数。
fn insert_after<T>(list: &mut DoublyList<T>, at: &Rc<RefCell<DNode<T>>>, elem: T) {
    let right = at.borrow().next.clone();
    let node = Rc::new(RefCell::new(DNode {
        elem,
        prev: Some(Rc::downgrade(at)),
        next: right.clone(),
    }));
    if let Some(r) = right {
        r.borrow_mut().prev = Some(Rc::downgrade(&node));
    } else {
        list.tail = Some(node.clone()); // at 原来是尾节点
    }
    at.borrow_mut().next = Some(node);
    list.len += 1;
}

fn detach<T>(list: &mut DoublyList<T>, node: &Rc<RefCell<DNode<T>>>) {
    let left = node.borrow().prev.as_ref().and_then(Weak::upgrade);
    let right = node.borrow().next.clone();

    match &left {
        Some(l) => l.borrow_mut().next = right.clone(),
        None => list.head = right.clone(), // 删除头节点
    }
    match &right {
        Some(r) => r.borrow_mut().prev = left.as_ref().map(Rc::downgrade),
        None => list.tail = left.clone(), // 删除尾节点
    }
    node.borrow_mut().prev = None;
    node.borrow_mut().next = None;
    list.len -= 1;
}代码先克隆左右句柄,再结束短暂的 RefCell 借用,避免在一次表达式中重叠借用同一节点。两个辅助函数还假定传入句柄确实属于该链表;生产接口应隐藏节点类型,防止混入其他链表的句柄。
detach 只摘下节点而不强行取出 T。外部若仍持有该节点的 Rc,Rc::try_unwrap 就不能成功;这说明共享所有权会直接影响“删除后能否返回元素所有权”的 API 设计。
prev;删除尾只更新新尾的 next;成功后恰好修改一次长度。把这些写成测试,比在代码里“凭感觉补分支”可靠。3. 进阶算法及变体
a. 快慢指针
快慢指针并不是某个固定算法,而是一种在同一条链上维持两个不同移动速度或不同间距的技巧。虽然链表不能用下标直接跳到目标位置,但两个指针之间的相对运动仍能编码长度与距离信息,并且只需要 额外空间。
一个最直接的用途是寻找单链表中点。令两个指针 slow 与 fast 都从首节点出发,slow 每轮前进一步,fast 每轮前进两步。当 fast 到达链尾时,它走过的距离约是 slow 的两倍,因此 slow 恰好位于中间。奇数长度链表只有一个中点;偶数长度链表有两个候选中点,下面的停止条件返回后一个中点。若希望返回前一个中点,可以在循环前进一步检查 fast.next.next 是否存在。
fast 走两步、slow 走一步;长度为 7 时,快指针到达节点 7,慢指针位于节点 4。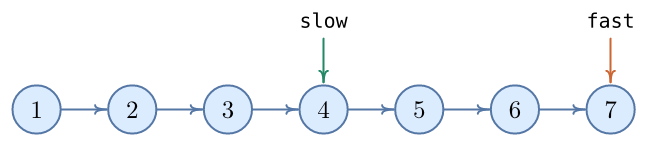
fn middle<T>(head: &Link<T>) -> Option<&T> {
    let mut slow = head.as_deref();
    let mut fast = head.as_deref();

    while let Some(next) = fast.and_then(|node| node.next.as_deref()) {
        slow = slow.and_then(|node| node.next.as_deref());
        fast = next.next.as_deref();
    }
    slow.map(|node| &node.elem)
}
相同思想还能用于寻找倒数第 个节点:先让 fast 前进 步,再让两个指针同速前进;fast 到达链尾时,slow 与链尾恰好相距 个节点。若预先前进不足 步就遇到链尾,说明 超过链表长度。相比先遍历一次求长度再遍历第二次,这种方法只需一次完整扫描。
快慢指针更著名的用途是 Floyd 判圈。让 slow 每次走一步、fast 每次走两步:若链表无环,快指针最终遇到空指针;若存在长度为 的环,两者进入环后每轮相对接近一步,至多再过 轮就会相遇。设表头到入环点距离为 ,相遇点距入环点为 ,慢指针走了 步,快指针则多绕了若干整圈,于是有 ,即 。把一个指针移回表头,并让两个指针都改为每次一步:前者走 步到入环点,后者从相遇点走 步也恰好补足若干整圈,两者再次相遇的位置就是入环点。
Box 独占后继的安全单链表不会形成环,所以 middle 可以直接借用节点,而 Floyd 判圈通常用于索引链表、共享节点结构或其他语言中的指针链。若以 Vec<Node> 和下标表示连接,快慢指针算法无需 unsafe,也能自然表示环。b. 链表反转
反转单链表要求把每条 u -> v 改成 v -> u,同时让旧尾节点成为新首节点。若直接改写当前节点的 next,就会丢失尚未处理的后半段,所以每轮必须同时保存三个角色:已经反转完成的前缀 prev、当前节点 curr、尚未处理的后继 next。
prev 指向已经反转的前缀,curr 指向尚未处理后缀的首节点。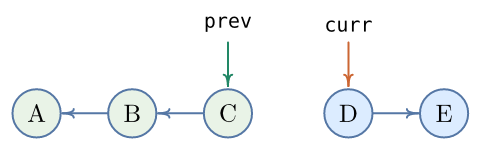
循环开始时保持如下不变量:prev 中节点次序已经反转,head 仍保持剩余节点的原次序,并且两部分合起来恰好包含原链表全部节点。每轮先从当前节点取下后继,再令当前节点指回 prev,最后同时向前推进两部分边界:
fn reverse<T>(mut head: Link<T>) -> Link<T> {
    let mut prev = None;
    while let Some(mut node) = head {
        head = node.next.take();
        node.next = prev;
        prev = Some(node);
    }
    prev
}
空链表不进入循环,结果仍为空;单节点链表只执行一轮,节点的后继仍为空。一般情况下每个节点只访问一次,时间为 ,除指针变量外不申请与 有关的空间,因此额外空间为 。
递归写法可以先反转 head.next,再令原后继指回 head,但它需要 调用栈,链表很长时存在栈溢出的风险。分组反转、区间反转也建立在同一不变量上:先确定需要反转的边界,只对区间内节点执行上述步骤,最后把反转后的首尾与区间外两侧重新连接。
take() 先把 node.next 设为 None,再取得后继链的所有权;随后 node.next = prev 把已经反转的前缀交给当前节点。每一步都只有一个所有者,因此不需要裸指针,也不会短暂形成两个节点同时拥有同一后继的状态。c. 跳表
有序链表能够在超过目标键时提前停止,却仍然只能逐节点前进。跳表在底层有序链表之上增加若干稀疏层:高层只保留少量节点,用于跨过大段区间;越接近底层,节点越密集。查询从最高层首部开始,只要右侧节点键仍小于目标就向右移动;若再向右会越过目标,就下降一层。到达第零层后,当前位置的后继就是唯一可能等于目标的节点。
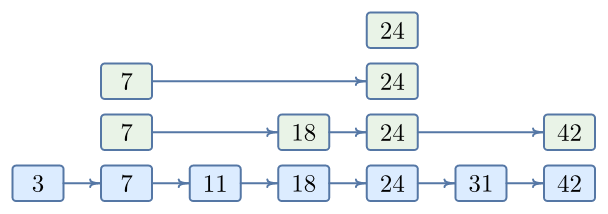
插入时,查询过程要额外记录每一层最后一个小于新键的节点,通常称为 update 数组。随机生成新节点层高后,在每一层把新节点接到 update[level] 与其原后继之间。删除使用同一数组,让各层前驱越过目标节点即可。结构本身不进行旋转,复杂性集中在查找路径和多层连接维护上。
节点通常必定出现在第零层,并以概率 继续晋升到下一层;于是达到至少第 层的概率为 。取 时,第 层期望只剩约 个节点,最高层数为 ,查询、插入和删除的期望复杂度也为 。随机结果仍可能产生很差的层高分布,所以最坏复杂度是 ;工程实现会设置最大层数,避免异常随机序列无限增长。
struct SkipNode<K, V> {
    key: K,
    value: V,
    next: Vec<Option<usize>>, // 第 i 项是第 i 层的后继下标
}

struct SkipList<K, V> {
    nodes: Vec<SkipNode<K, V>>,
    head: Vec<Option<usize>>, // 哨兵在各层的首个后继
    levels: usize,
}
使用下标而非节点引用后,每个节点的 next 长度就是它的塔高,head[level] 相当于该层的哨兵后继。查询得到目标后,从第零层沿后继继续前进即可进行有序范围扫描。正因这种顺序扫描自然、更新只涉及局部连接,跳表常用于内存有序索引以及 LSM-tree 的 memtable;它也比需要多种旋转的平衡树更容易设计细粒度并发版本。
Vec 或槽位表,以 usize 连接;支持删除复用时再加入代际索引。这样算法主体仍是“沿层移动”,Rust 特有的存储问题则被限制在节点池内部。4. 当今链表的应用
现代 CPU 以缓存行为为中心,而链式节点分散,不仅额外指针放大内存占用,零碎内存分配对于操作系统来说也更加昂贵,并且缓存难以命中导致性能下降。因此大量业务代码用 Vec、VecDeque、紧凑 B 树或“数组 + 索引”来替代传统链表。不过,链表仍适合侵入式调度队列、内核对象表、内存分配器的空闲块、LRU 中“哈希表 + 双链表”的顺序维护,以及要求并行或节点地址稳定的场景。
三、栈
栈的抽象只有后进先出:最后压入的元素最先弹出。它至少提供 push、pop 和 peek 三个操作。注意:栈只关心数据的访问顺序,而不关心数据的存储方式,因此底层实现既可以使用顺序表也可以使用链表。这正是“接口与实现分离”的意义:调用者依赖后进先出的行为契约,而不是依赖 Vec 的某个具体字段。只要新实现仍满足同一契约,库作者便可以在不改业务逻辑的前提下替换内存布局、加入容量限制或记录统计信息。
push 与 pop 都只作用于栈顶,底部元素不会被直接访问。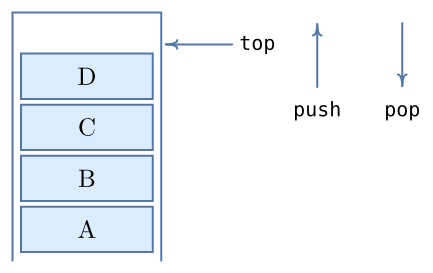
例如,一种基于顺序表的栈的实现方式如下:
pub trait Stack<T> {
    fn push(&mut self, value: T);
    fn pop(&mut self) -> Option<T>;
    fn peek(&self) -> Option<&T>;
    fn is_empty(&self) -> bool;
}
impl<T> Stack<T> for Vec<T> {
    fn push(&mut self, v: T) { Vec::push(self, v) }
    fn pop(&mut self) -> Option<T> { Vec::pop(self) }
    fn peek(&self) -> Option<&T> { self.last() }
    fn is_empty(&self) -> bool { Vec::is_empty(self) }
}
表达式求值、括号匹配、深度优先搜索等看似毫无关系的问题,实质上底层都需要保存“尚未处理完、稍后按相反顺序恢复”的状态,而这便是栈显露手脚的地方。
1. 顺序栈与链式栈
顺序栈以 Vec 尾部作为栈顶,push 对应 Vec::push,pop 对应 Vec::pop,两者摊还 且缓存友好,通常是首选。链式栈就是只在头部插删的单链表,每次操作最坏 ,也不会因为扩容整体移动元素,但每个元素都需要一次独立分配。
Vec<T> 实现的栈容器本身只在调用栈上保存三个机器字,真正的元素位于堆上。把递归 DFS 改成显式 Vec 栈,正是把不可控的调用栈消耗转化为可增长的堆内存。2. 主流语言中栈的实现方式
Rust 通常直接使用 Vec<T>;C++ 的 std::stack 是容器适配器,默认底层为 deque;Java 的旧 Stack 继承 Vector,新代码通常以 ArrayDeque 实现 Deque 接口。共同趋势是保留栈接口、复用成熟顺序容器,而非单独维护链式栈。
四、队列
队列提供先进先出的 enqueue 与 dequeue:新元素从队尾进入,旧元素从队首离开。操作系统的就绪任务、网络数据包和图的广度优先遍历都具有这种“先到先处理”的语义。
1. 顺序队列
a. 基本表示
最直接的顺序队列是在一段固定数组中连续存放元素,并维护队首下标 front 与下一个可写位置 rear。初始时二者都为零;入队把元素写入 array[rear],再令 rear += 1;出队读取 array[front],再令 front += 1。队列中的有效区间始终是半开区间 ,因而 front == rear 表示队空。只要队尾尚未抵达数组末端,入队和出队都只改一个下标,时间复杂度为 。
这种实现虽然简单,却没有真正解决数组空间的重复利用问题。设容量为 8,先入队 8 个元素,再出队前 5 个元素。此时下标 0 至 4 已经空闲,队列中实际上只剩 3 个元素;然而 rear == 8,队尾已经越过数组的最后一个槽位,新的元素仍然无法写入。队列“逻辑上未满、表示上却无法继续入队”的现象称为假溢出。
b. 为什么不能简单搬移元素
一种补救方法是在每次出队后,把余下元素整体向数组开头移动,使 front 重新变为零;这样确实能够回收前部空间,但一次出队需要移动 个元素,复杂度从 退化为 。也可以等到 rear 抵达末端时再集中搬移,这只把成本推迟到了某一次入队,并没有消除搬移;在实时任务或延迟敏感的系统中,这种偶发的长停顿同样不可忽略。
真正需要改变的不是元素,而是“逻辑位置如何对应物理槽位”。当队尾抵达数组末端,而数组开头已经因出队出现空槽时,若允许队尾回到下标零继续写入,所有已释放空间便都能复用。由此自然得到环形队列。
2. 环形队列与链式队列
a. 环形队列
环形队列把长度为 的数组首尾视为相接:逻辑下标 对应物理下标 。因此,推进队首使用 ,推进队尾也使用相同规则。所谓“环形”只是下标的解释方式发生回绕,内存中的数组本身仍是一段普通的连续空间;它以常数时间的下标计算消除了顺序队列的假溢出与元素搬移。
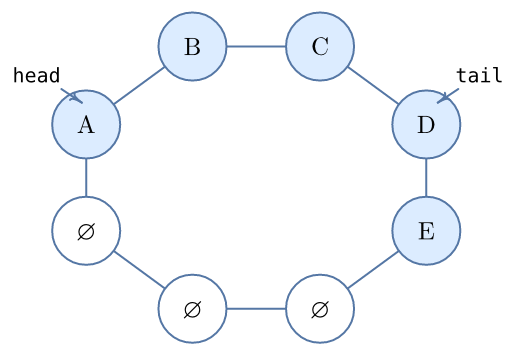
pub struct RingQueue<T> {
    buf: Vec<Option<T>>, head: usize, len: usize,
}
impl<T> RingQueue<T> {
    pub fn with_capacity(cap: usize) -> Self {
        assert!(cap > 0);
        Self { buf: (0..cap).map(|_| None).collect(), head: 0, len: 0 }
    }
    pub fn enqueue(&mut self, x: T) -> Result<(), T> {
        if self.len == self.buf.len() { return Err(x); }
        let tail = (self.head + self.len) % self.buf.len();
        self.buf[tail] = Some(x); self.len += 1; Ok(())
    }
    pub fn dequeue(&mut self) -> Option<T> {
        if self.len == 0 { return None; }
        let x = self.buf[self.head].take();
        self.head = (self.head + 1) % self.buf.len(); self.len -= 1; x
    }
}
Option<T> 精确表示槽位是否已初始化,避免从未初始化内存读取 T。入队时先检查满,再计算尾位置并写入;出队时先检查空,通过 take() 取走元素并留下 None,最后推进头下标。更新次序看似无关紧要,但若将来把队列改造成并发结构,写入元素与发布新尾位置之间还必须建立正确的内存顺序。
实现中还必须区分“队首与队尾下标相同”究竟表示空还是满。上面的代码额外保存 len,于是 len == 0 表示空、len == capacity 表示满;另一种常见约定是故意空出一个槽位,以 front == rear 表示空、(rear + 1) % capacity == front 表示满,但其可用容量会比数组长度少一。两种约定都正确,关键是始终维持同一套不变量。
Option<T> 与 take() 是 Rust 用来安全表示“槽位当前没有已初始化元素”的方式;它们服务于内存安全,并不是环形队列算法本身的必要组成。其他语言可以用长度、状态位或受控的未初始化存储表达同一算法。b. 链式队列
链式队列为每个元素分配一个节点,并同时保存头指针与尾指针。入队把新节点接到旧尾节点之后并更新尾指针;出队移走头节点并让头指针指向其后继。只要两个指针都被维护,两种操作都是 ,而且不会出现固定数组意义上的“满”。当最后一个节点被移走时,头、尾必须同时恢复为空,否则尾指针会悬空。
链式表示以逐节点分配、额外指针和较差的缓存局部性换取了无需搬移、容量按节点增长以及节点地址稳定。它适合节点本来就属于其他链式结构,或必须长期保持地址稳定的场景;作为普通 FIFO 容器时,能够增长的环形缓冲区通常具有更好的常数性能。
3. 变体
a. 双端队列
双端队列允许两端插删。Rust 的 VecDeque 是可增长环形缓冲区,两端操作摊还 ;由于发生回绕,元素可能分成两段,可用 make_contiguous 旋转成连续切片。
b. 优先队列
优先队列取出的不是最早进入者,而是优先级最高者。Rust 的 BinaryHeap 是最大二叉堆:查看堆顶 、插入和弹出 。它将在树与堆中完整实现;此处只需记住,“队列”描述接口顺序,“堆”描述一种实现。
c. 阻塞队列
阻塞队列在空时让消费者等待、满时让生产者等待。它不只是一种容器,还包含并发同步协议。Rust 可用 std::sync::mpsc::sync_channel 获得有界通道,或用 Mutex<VecDeque<T>> + Condvar 实现;等待必须放在循环中重新检查条件,以防虚假唤醒。
4. 主流语言中队列的实现方式
容器的名称并不能说明其布局。判断一种队列属于顺序、环形还是链式实现,应继续查看它怎样存放元素、怎样复用队首释放的空间,以及扩容时是否需要重排元素。
| 语言 | 常用队列类型 | 实际布局 |
|---|---|---|
| Rust | VecDeque<T> | 可增长环形缓冲区 |
| Java | ArrayDeque<E> | 可增长环形数组 |
| Java | ArrayBlockingQueue<E> | 定长环形数组 |
| Java | LinkedList<E>LinkedBlockingQueue<E> | 链式 |
| C++ | std::queue<T> | 容器适配器,默认底层为 std::deque<T> |
因此,Rust 的标准通用队列应归为可增长环形顺序存储,Java 同时提供数组式与链式选择,而 C++ 的 std::queue 应先看它适配的底层容器,不能脱离模板参数简单归类。[1], [2], [3], [4]
五、总结
| 结构 | 随机访问 | 端部插删 | 中间插删 | 优先场景 |
|---|---|---|---|---|
| 顺序表 | 尾部摊还 | 默认选择、遍历密集 | ||
| 链表 | 已知节点 | 已知节点 | 稳定地址、拼接 | |
| 栈 | — | — | 回溯、解析、调用帧模型 | |
| 环形队列 | 摊还 | 任务缓冲、双端调度 | ||
| 优先队列 | 仅堆顶 | — | 调度、最短路 |
选择结构时先写出需要的接口,再看数据规模、缓存局部性、地址稳定性与并发约束。大多数情况下,连续或分块连续的布局比“教科书上指针操作次数更少”的链表更快。
Bibliography
- [1] The Rust Project Developers, “VecDeque in std::collections.” [Online]. Available: https://doc.rust-lang.org/std/collections/struct.VecDeque.html
- [2] Oracle, “ArrayDeque (Java SE 26).” [Online]. Available: https://docs.oracle.com/en/java/javase/26/docs/api/java.base/java/util/ArrayDeque.html
- [3] Oracle, “ArrayBlockingQueue (Java SE 26).” [Online]. Available: https://docs.oracle.com/en/java/javase/26/docs/api/java.base/java/util/concurrent/ArrayBlockingQueue.html
- [4] International Organization for Standardization, “C++ Working Draft: Container Adaptors and Class Template queue.” [Online]. Available: https://eel.is/c++draft/queue
- [5] The Rust Project Developers, “BinaryHeap in std::collections.” [Online]. Available: https://doc.rust-lang.org/std/collections/struct.BinaryHeap.html
- [6] The Rust Project Developers, “LinkedList in std::collections.” [Online]. Available: https://doc.rust-lang.org/std/collections/struct.LinkedList.html