查找算法
 Illustrated by
不同算法的差别不只在 与 :它们依赖的数据不变量、预处理与更新成本、内存访问模式和返回语义都不同。一次性查询常直接扫描;大量查询值得预先排序或建立索引;等值、范围、前驱、后继和顺序统计量又对应不同结构。评价查找方案时,必须把“建立索引一次、维护索引若干次、执行查询若干次”放在同一成本模型中。
一、顺序查找与二分查找
1. 顺序查找
顺序查找(sequential search)不要求候选具有任何次序,从第一个元素开始逐个验证谓词,命中便返回,扫描完仍未命中则报告失败。它适用于无序数据、链表、流式输入、只能使用一次的数据和很小的集合。
a. 算法过程与不变量
- 从下标 0 开始考察元素。
- 若当前元素满足条件,立即返回当前位置;否则进入下一位置。
- 到达数组末尾仍未命中,返回
None。
处理下标 之前的循环不变量是:区间 [0, i) 中不存在目标。比较失败便把当前元素加入已排除区间;比较成功则直接得到答案。这个证明看似简单,却说明返回失败必须建立在完整扫描之上,不能因为若干连续不匹配就提前结束。
fn linear_search<T: PartialEq>(values: &[T], target: &T) -> Option<usize> {
    for (index, value) in values.iter().enumerate() {
        if value == target {
            return Some(index);
        }
    }
    None
}
b. 复杂度与现实性能
目标恰在首位时只比较一次,为 ;目标不存在或位于末尾时比较 次,为 。若目标在各位置等概率出现,成功查找平均比较约 次,数量级仍为 。额外空间为 。
线性复杂度不等于现实中必然缓慢。数组扫描具有连续访存、容易预取和便于向量化等优势;哈希和树结构虽然减少比较次数,却可能引入哈希计算、指针跳转和缓存缺失。因此只有几十个简单元素时,扫描可能比建立索引更便宜。若数据持续到达且不能回看,顺序查找还可能是唯一可行方式。
2. 二分查找
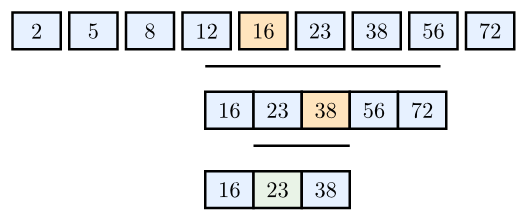
lower_bound(target) 时,谓词是 a[i] >= target。有序只是最常见的单调来源,二分的本质是寻找真假分界。a. 半开区间与 lower bound
维护候选半开区间 [lo, hi),初始为 [0,n)。取 mid = lo + (hi-lo)/2:若 a[mid] < target,则 mid 及其左侧都不可能是第一个不小于目标的位置,令 lo=mid+1;否则 mid 仍可能是答案,令 hi=mid。区间为空时 lo==hi,这个位置既可以是命中下标,也可以是保持有序的插入位置。
fn lower_bound<T: Ord>(values: &[T], target: &T) -> usize {
    let mut low = 0;
    let mut high = values.len();

    while low < high {
        let middle = low + (high - low) / 2;
        if values[middle] < *target {
            low = middle + 1;
        } else {
            high = middle;
        }
    }
    low
}

fn upper_bound<T: Ord>(values: &[T], target: &T) -> usize {
    let mut low = 0;
    let mut high = values.len();

    while low < high {
        let middle = low + (high - low) / 2;
        if values[middle] <= *target {
            low = middle + 1;
        } else {
            high = middle;
        }
    }
    low
}
b. 正确性与复杂度
low 的元素严格小于目标,所有下标不小于 high 的元素不小于目标,而答案位于闭合的边界位置区间 [low,high]。每次比较均保持不变量并严格缩短 high-low;终止时两端相等,该位置左侧全小于目标、右侧全不小于目标,故它正是 lower bound。每次迭代至少把候选长度减半,所以比较次数为 ,额外空间为 。使用 low + (high-low)/2 避免 low+high 在固定宽度整数上溢出。upper_bound 只把判断改为“小于或等于目标”,它返回第一个严格大于目标的位置。因此 [lower_bound(x), upper_bound(x)) 恰好是所有等值元素所在区间,其长度就是出现次数。
c. 命中、插入位置与重复元素
求边界比只求“任意一个命中”更通用:若 lower < values.len() 且 values[lower] == target,目标存在;否则 lower 是保持数组有序的插入位置。重复键存在时,普通 binary_search 返回哪一个重复位置通常不应依赖,而边界接口可以稳定表达第一个、最后一个和全部匹配。
slice::binary_search 命中时返回某个匹配下标,不承诺是第一个;未命中返回可保持有序性的插入位置。需要处理重复键边界时,应使用 partition_point 或手写 lower/upper bound。二、二叉搜索树查找
1. 查询过程
从根开始比较目标与当前键:相等则命中;目标较小只可能位于左子树;目标较大只可能位于右子树。每次排除整棵不可能的子树,直至命中或走到空指针。查找访问的节点数不超过树高 ,所以时间为 。
use std::cmp::Ordering;

struct Node<K, V> {
    key: K,
    value: V,
    left: Option<Box<Node<K, V>>>,
    right: Option<Box<Node<K, V>>>,
}

fn get<'a, K: Ord, V>(
    mut current: Option<&'a Node<K, V>>,
    key: &K,
) -> Option<&'a V> {
    while let Some(node) = current {
        match key.cmp(&node.key) {
            Ordering::Less => current = node.left.as_deref(),
            Ordering::Greater => current = node.right.as_deref(),
            Ordering::Equal => return Some(&node.value),
        }
    }
    None
}
Rust 中 as_deref() 把 Option<&Box<Node<...>>> 转成 Option<&Node<...>>,使变量在循环中始终保存对节点本身的共享借用。查找不改变树,因此只需要 &Node;插入和删除才需要沿路径取得可变所有权位置。
2. 高度退化与操作能力
若插入顺序近似随机,普通 BST 往往较矮,但它没有最坏平衡保证。把递增键依次插入空树会让每个节点都只有右孩子,树退化为链,查找从 变成 。不能把“二叉搜索树查询是对数时间”当作无条件结论;严格表述应是 。
与有序数组二分相比,BST 能在不整体搬移元素的情况下插入和删除,还能沿父子关系求最小值、最大值、前驱、后继及范围迭代。但每个节点单独分配,指针追逐造成较多缓存缺失,且节点还要支付指针与分配器元数据开销。静态数据通常更适合排序数组,频繁动态更新且需要顺序能力时才考虑树。
三、平衡树查找
1. AVL 与红黑树中的查询
AVL 树要求任一节点左右子树高度差至多为 1,因此高度控制更严格,查询路径通常较短;红黑树用颜色与黑高规则给出较宽松的平衡,更新时往往需要较少旋转。二者的查询代码与普通 BST 几乎相同,区别主要发生在插入、删除后的旋转和重新着色。
2. 范围查询为什么适合有序树
查找所有键值满足 的元素时,先用对数时间定位第一个不小于 的节点,再沿中序后继持续输出,直到键达到 。若结果数为 ,总时间可写成 ;输出本身已经需要 。哈希表无法自然地从一个键走向相邻键,而有序树把这种关系直接编码在遍历顺序中。
平衡树的优势不是在所有场景击败哈希表的平均等值查询,而是同时提供顺序、范围、最值、前驱后继和稳定的最坏界。代价则是每个操作包含多次比较与指针访问,并为平衡元数据付出空间。
四、B 树 / B+ 树查找
1. 节点内查找与向下导航
查询键 到达某节点后,先在节点的有序键数组中执行 lower bound。若节点本身保存记录且键相等即可返回;否则 lower bound 的位置决定应进入哪一个孩子。下降到叶节点仍未找到便报告失败。设平均分支因子为 ,容纳 个键的树高约为 ;节点内虽然还要比较多个键,但它们位于连续页中,常可二分或利用缓存快速扫描。
2. 为什么数据库偏爱 B+ 树
数据库关注的主要成本不是 CPU 比较,而是访问磁盘页或缓冲池页。一个 16 KiB 页能容纳大量分隔键,使分支因子达到数百;即使索引包含数百万乃至更多记录,高度通常仍很小。B+ 树内部页不保存完整记录,可放下更多导航键;叶页相连又让范围扫描从随机 I/O 转为顺序读取。
复合索引把多个字段按指定顺序连接成复合键,因此通常遵循最左前缀:索引 (a,b,c) 可以有效支持先约束 a 再处理 b 的查询,却不能一般地跳过 a 直接按 b 定位。排序方向、选择率、回表成本与数据统计也会影响执行计划;查询条件中出现索引字段,不等于优化器一定采用该索引。
五、哈希查找
1. 查询过程
在链地址表中,算法定位桶后遍历桶内记录;在开放地址表中,从初始槽位开始按探测序列检查,遇到目标即成功,遇到从未占用的空槽即可失败,遇到删除标记则必须继续。负载因子过高会拉长冲突链或探测簇,所以扩容并重新散列是维持平均常数时间的重要条件。
分布良好且负载受控时,等值查找期望为 ;所有键严重碰撞时仍可能退化为 。这个平均界包含计算哈希、探测和相等比较的成本。长字符串键需要读取许多字节才能计算哈希,小集合上线性扫描可能反而更快。
2. 能做什么与不能做什么
哈希表适合成员测试、去重、计数与键值映射,却没有保留键的全序,因此不能自然提供范围、最近值、最小值或按序遍历。若业务同时需要快速等值查找和有序范围查询,通常要维护两个索引,或直接选择有序树并接受较高的等值查询常数。
六、主流语言中查找算法的实现方式
标准库不是为“查找”只提供一个万能函数,而是按数据是否有序、是否需要范围和是否动态更新分流。调用者首先要理解返回语义,再选择容器;不能看到函数名含 search 就忽略它的前置条件。
1. Rust
切片的 binary_search 命中时返回 Ok(index),未命中返回 Err(insertion_index);重复元素存在时只保证返回其中一个。partition_point(predicate) 直接寻找单调谓词的真假边界,可以分别表达 lower bound 与 upper bound:
let lower = values.partition_point(|value| value < &target);
let upper = values.partition_point(|value| value <= &target);
let occurrences = &values[lower..upper];
动态等值映射通常选择 HashMap,动态有序映射选择 BTreeMap。后者的 range 可以按键区间迭代,成本由定位边界与输出数量共同组成。标准容器封装了内部表示,程序应依赖稳定性、顺序和复杂度语义,而不是假设具体节点阶数或哈希探测方式。[1]
2. Java
Arrays.binarySearch 对基本类型数组和对象数组提供多组重载。成功时返回某个匹配下标;失败时返回 -(insertionPoint)-1,调用者可用 -result-1 还原插入位置。之所以不直接返回负插入点,是因为插入点 0 也需要与成功下标 0 区分。数组必须按同一自然顺序或比较器预先排序,否则结果没有定义上的意义。
Collections.binarySearch 面向 List,但链表不具备常数时间随机访问;即便接口可调用,也可能无法获得数组二分的现实性能。等值映射由 HashMap 提供,有序范围由 TreeMap 提供。[2]
3. C++
C++ 把边界语义拆得最明确:std::lower_bound 返回第一个不小于目标的位置,std::upper_bound 返回第一个大于目标的位置,std::equal_range 一次返回二者组成的区间,std::binary_search 只回答是否存在。返回值是迭代器而不是整数下标,因而可统一作用于多种随机访问或前向区间。
这些算法要求区间已经按同一比较关系分区。std::map、std::set 自身维护有序树索引,应调用成员函数 find、lower_bound,避免把树迭代器交给通用二分算法后做大量线性迭代器移动;无序版本则提供平均常数等值查找。[3]
| 方法 | 查询 | 准备/更新 | 适用条件 |
|---|---|---|---|
| 顺序 | 无 | 无序、小规模、一次性 | |
| 数组二分 | 排序 | 静态有序、随机访问 | |
| 平衡树 | 动态有序、范围 | ||
| B+ 树 | 按树高 | 页分裂合并 | 外存索引 |
| 哈希 | 平均 | 平均 | 等值查询 |
七、总结
无序且查询少时顺序扫描;静态有序数组用二分及边界变体;动态有序集合用平衡树;外存和范围扫描用 B+ 树;大量等值查询用哈希表。复杂度必须连同建立索引和维护索引的成本计算,不能只比较一次查询。
Bibliography
- [1] The Rust Project Developers, “Primitive Type slice.” [Online]. Available: https://doc.rust-lang.org/std/primitive.slice.html
- [2] Oracle, “Arrays (Java SE 26).” [Online]. Available: https://docs.oracle.com/en/java/javase/26/docs/api/java.base/java/util/Arrays.html
- [3] International Organization for Standardization, “C++ Working Draft: Binary Search.” [Online]. Available: https://eel.is/c++draft/alg.binary.search