字符串算法
 Illustrated by
字符串算法研究离散符号序列。实际程序还要区分字节、Unicode 标量值和用户感知字符:算法中的“字符”必须先确定所属字母表与索引单位。Rust 的 String 是 UTF-8 字节序列,不能用整数直接索引;ASCII 算法可在 as_bytes() 上运行,Unicode 文本则需按 chars() 或字素簇库明确语义。
一、字符串的定义
定义中的“符号”并不自动等于一个 UTF-8 字节。对 ASCII 文本可令 并在字节切片上运行;对 Unicode 标量值可把 char 当作符号;若问题关心用户看到的一个字符,还要按字素簇切分。算法下标属于所选符号序列,不能把字节下标误当成字符序号。
连接运算把 与 拼成 。它满足结合律而不满足交换律,且空串是单位元。明确这些基础对象之后,模式匹配才能准确说明“匹配发生在哪个索引单位、返回什么位置、空模式如何处理”。
二、字符串匹配
算法之间的区别在于失配后能够排除多少不可能的起点。暴力法几乎不复用信息;Rabin–Karp 复用相邻窗口哈希;KMP 复用已匹配前缀的边界;Boyer–Moore 则从模式右端比较并用字符分布跳跃。
1. 暴力匹配算法
对每个起点逐字符比较,最坏 、空间 。它没有预处理,模式很短或文本很小时常是合理基线;优化库还可先用向量指令搜索首字节,再验证候选。
fn naive_find(text: &[u8], pattern: &[u8]) -> Vec<usize> {
    if pattern.len() > text.len() {
        return Vec::new();
    }
    (0..=text.len() - pattern.len())
        .filter(|&i| &text[i..i + pattern.len()] == pattern)
        .collect()
}
2. Rabin-Karp 算法
Rabin–Karp 为长度 的窗口维护滚动哈希。例如在模数 下
窗口右移时减去最高位、乘 、加新字符即可 更新。哈希相等只是候选,仍须逐字符验证以避免碰撞;期望 ,恶意碰撞时 。双模或 64 位自然溢出降低随机碰撞,但要求绝对正确时不能省略验证。
fn rabin_karp(text: &[u8], pattern: &[u8]) -> Vec<usize> {
    let m = pattern.len();
    let base = 911_382_323_u64;
    if m == 0 {
        return (0..=text.len()).collect();
    }
    if m > text.len() {
        return Vec::new();
    }

    let mut highest_power = 1_u64;
    for _ in 1..m {
        highest_power = highest_power.wrapping_mul(base);
    }

    let mut pattern_hash = 0_u64;
    let mut window_hash = 0_u64;
    for i in 0..m {
        pattern_hash = pattern_hash
            .wrapping_mul(base)
            .wrapping_add(pattern[i] as u64);
        window_hash = window_hash
            .wrapping_mul(base)
            .wrapping_add(text[i] as u64);
    }

    let mut matches = Vec::new();
    for start in 0..=text.len() - m {
        if pattern_hash == window_hash && &text[start..start + m] == pattern {
            matches.push(start);
        }
        if start + m < text.len() {
            window_hash = window_hash
                .wrapping_sub((text[start] as u64).wrapping_mul(highest_power))
                .wrapping_mul(base)
                .wrapping_add(text[start + m] as u64);
        }
    }
    matches
}
3. KMP 算法
对模式串 ,前缀函数 定义为前缀 的最长边界长度:
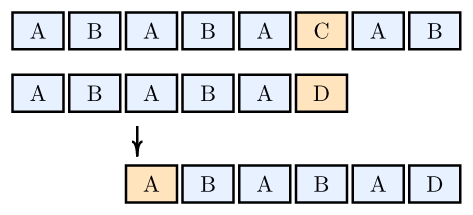
KMP 的关键不是记住一句“失配就跳 pi”,而是解释为什么这个跳跃不会遗漏答案。假设文本已经与 匹配,现在 text[i] != pattern[j]。任何仍可能延续的模式前缀,必须同时是已匹配串 的后缀;否则它无法与文本指针前方刚刚匹配的字符对齐。最长这样的候选长度正是 pi[j - 1],所以可以令 j = pi[j - 1],保持文本下标 i 不动并继续比较。
a. 构造前缀函数
逐个计算 pi[i] 时,令 j = pi[i - 1],先尝试把前一个前缀的最长边界扩展一个字符。如果 pattern[i] != pattern[j],说明该边界不能扩展,就沿边界链退到 pi[j - 1];这些更短候选仍是当前已匹配后缀。字符相等时把 j 加一,最终写入 pi[i]。
以 P = ABABAC 为例,前缀函数依次为 [0, 0, 1, 2, 3, 0]。处理最后一个 C 时先尝试长度 3 的边界 ABA,比较 C 与 B 失败;退到长度 1 后比较 C 与 B 仍失败;再退到 0,比较 C 与 A 失败,因此最后为 0。这个过程不是重新从头扫描此前字符,而是沿已经计算好的边界链跳转。
fn prefix_function(pattern: &[u8]) -> Vec<usize> {
    let mut pi = vec![0; pattern.len()];

    for i in 1..pattern.len() {
        let mut j = pi[i - 1];
        while j > 0 && pattern[i] != pattern[j] {
            j = pi[j - 1];
        }
        if pattern[i] == pattern[j] {
            j += 1;
        }
        pi[i] = j;
    }
    pi
}
b. 扫描文本
扫描时 j 始终表示模式前缀中已经匹配的字符数,并维持不变量
对当前文本字符 text[i],先沿前缀函数处理所有可能失配,再在相等时扩展 j。当 j == m 时,匹配起点为 i + 1 - m。报告匹配后不能简单把 j 清零,因为两个匹配可能重叠;应令 j = pi[m - 1],继续保留完整模式的最长边界。
fn kmp_find_all(text: &[u8], pattern: &[u8]) -> Vec<usize> {
    if pattern.is_empty() {
        return (0..=text.len()).collect();
    }

    let pi = prefix_function(pattern);
    let mut matches = Vec::new();
    let mut j = 0;

    for (i, &byte) in text.iter().enumerate() {
        while j > 0 && byte != pattern[j] {
            j = pi[j - 1];
        }
        if byte == pattern[j] {
            j += 1;
        }
        if j == pattern.len() {
            matches.push(i + 1 - pattern.len());
            j = pi[j - 1];
        }
    }
    matches
}
c. 为什么文本指针不回退
失配前已经知道文本后缀等于 P[0..j)。把模式退到它的某条边界,就是把相同的前缀重新对齐到这个文本后缀;文本当前位置还没有被任何候选成功匹配,因此继续拿同一字符比较即可。比最长边界更长的候选已由失配排除,不是边界的候选又无法覆盖此前匹配片段,所以跳跃不会越过合法匹配。
d. 复杂度证明与边界条件
j 增加的总次数不超过扫描指针前进次数;while 每执行一次都会严格减小 j,所以减少次数也不超过此前增加次数。即使单个字符触发多次回退,整个过程的总回退次数仍是线性的。实现还需决定空模式语义:上面的函数把空串视为在每个字符边界都匹配,因此返回 0..=text.len()。如果接口只查找第一次出现,也可按标准库习惯返回 0。代码在 &[u8] 上运行,返回字节下标;直接用于 UTF-8 文本时,模式与文本只要来自合法字符串,匹配起点仍会落在字符边界,但“第几个字符”需要另行换算。
4. Boyer-Moore 算法
Boyer–Moore 从模式右端向左比较。坏字符规则把文本失配字符与模式中最右相同字符对齐;好后缀规则把已匹配后缀与模式内另一处或其最长可匹配前缀对齐。实际文本上常跳过多个位置,平均性能优秀;完整预处理和最坏界较复杂。Horspool 只保留简化坏字符表,工程上更易实现。
fn horspool(text: &[u8], pattern: &[u8]) -> Option<usize> {
    let m = pattern.len();
    if m == 0 {
        return Some(0);
    }

    let mut shift = [m; 256];
    for i in 0..m - 1 {
        shift[pattern[i] as usize] = m - 1 - i;
    }

    let mut end = m - 1;
    while end < text.len() {
        let mut j = m - 1;
        while pattern[j] == text[end - (m - 1 - j)] {
            if j == 0 {
                return Some(end + 1 - m);
            }
            j -= 1;
        }
        end += shift[text[end] as usize];
    }
    None
}
5. 双端匹配
双端匹配先比较模式两端或选择稀有锚点,再验证内部,使随机文本中的失败更早发生。它不是单一标准算法,而是一类减少无效字符比较的策略;Rust 字符串搜索实现会依据模式长度和平台采用专门化路径。算法正确性仍要求任何跳跃都不能越过可能匹配位置。
6. 主流语言中字符串匹配算法的实现方式
标准接口通常不承诺具体算法。Rust str::find/contains 通过 Pattern 抽象处理字符、字符串和谓词;Java String.indexOf、C++ basic_string::find 规定结果而允许实现更换搜索策略。调用者应依赖字节/字符语义、返回下标和复杂度保证,不应假设一定使用 KMP 或 Boyer–Moore。[1]
三、多模式匹配
逐个运行单模式算法会重复扫描文本;Trie 与 AC 自动机共享公共前缀并让文本只前进一次。
1. Trie 树
插入和查询复杂度与字符串长度成正比,与已存模式数无直接关系。稠密固定字母表可用定长孩子数组,稀疏 Unicode 字母表可用 HashMap/有序映射,空间和速度取舍不同。
use std::collections::HashMap;

#[derive(Default)]
struct TrieNode {
    next: HashMap<u8, usize>,
    terminal: bool,
}

struct Trie {
    nodes: Vec<TrieNode>,
}

impl Trie {
    fn new() -> Self {
        Self {
            nodes: vec![TrieNode::default()],
        }
    }

    fn insert(&mut self, word: &[u8]) {
        let mut current = 0;
        for &byte in word {
            let next = if let Some(&child) = self.nodes[current].next.get(&byte) {
                child
            } else {
                let child = self.nodes.len();
                self.nodes.push(TrieNode::default());
                self.nodes[current].next.insert(byte, child);
                child
            };
            current = next;
        }
        self.nodes[current].terminal = true;
    }

    fn contains(&self, word: &[u8]) -> bool {
        let mut current = 0;
        for &byte in word {
            let Some(&child) = self.nodes[current].next.get(&byte) else {
                return false;
            };
            current = child;
        }
        self.nodes[current].terminal
    }
}
借用冲突通过“先只读查询孩子,再在不存在时扩展节点数组并写回边”解决;若在持有 &mut self.nodes[u] 时直接 push,扩容可能使该引用失效,借用检查器会正确拒绝。
2. AC 自动机
Aho–Corasick 在 Trie 上增加失败指针。节点 的失败指针指向当前路径字符串的最长真后缀,且该后缀也是 Trie 前缀。BFS 按深度构造:根孩子失败到根;处理边 时,沿 fail[v] 找到可走字符 的状态。匹配失效便沿失败边退回,成功转移则前进,并输出当前节点及失败链继承的全部模式。
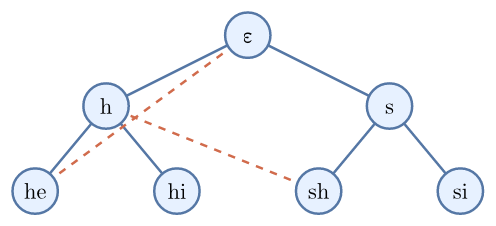
在转移表补全后,构造约为模式总长度乘字母表处理成本,扫描文本为 , 是输出匹配数;报告结果本身不可能快于 。
Rust 实现可在 Trie 节点上增加 fail: usize 与 out: Vec<usize>。构造时用 VecDeque BFS;为避免同时可变借用父、失败状态和孩子,先把当前节点的出边复制成 (char, child) 小列表,再逐项计算并写入 fail[child]。扫描时用 while state!=0 && !next.contains_key(c) 沿失败边回退,成功转移后遍历 out[state] 报告模式编号。
四、字符串哈希
预计算前缀值与幂可使任意子串哈希 :若 ,则
它可用于二分最长公共前缀、回文判断和重复子串候选,但碰撞意味着哈希相等不等于字符串相等。竞赛可接受随机双哈希的极低错误率;存储去重、安全边界和不可信输入应验证或使用确定性结构。
五、字符串的数据结构
1. 前缀树
前缀树即 Trie,强调以公共前缀组织键。它支持自动补全、路由前缀与词典查询;压缩 Trie 把只有一个孩子的链合并为字符串边,Patricia/Radix Tree 因而显著减少节点。前缀搜索时间与查询前缀长度加输出量相关。
2. 后缀树
朴素构造 空间和更高时间,Ukkonen 等算法可线性构造,但实现复杂。后缀树能在线性预处理后快速做子串、重复和最长公共子串查询;工程中常以更紧凑的后缀数组、LCP 数组或后缀自动机替代。
六、其他算法
1. 字典序
设 是严格全序字母表, 是其上所有有限字符串的集合。字母表上的顺序在 上诱导二元关系 。对任意 ,令 为 的最长公共前缀,则定义
当且仅当下列条件之一成立:
- 且 ,即 是 的真前缀;
- 存在 及 ,使
关系 称为由 诱导的字典序。因此字典序首先是定义在字符串集合 上的顺序关系,而不是一套逐字符执行的比较步骤。
a. 判断两个字符串的大小
上面的定义给出的是关系本身。把它实现成算法时,才需要从左到右求两个字符串的公共前缀:若在公共长度内遇到第一对不同字符,就使用字母表次序返回结果;若一直没有不同字符,则最长公共前缀必等于较短字符串,此时按真前缀条件令较短者在前。
因此不能一开始比较总长度。例如 "z" 大于 "aa",虽然它更短;两串的最长公共前缀为空,第一对字符已经满足 a < z,长度不再参与判定。Rust 的字节切片已经实现这种顺序,下面仍将定义直接翻译成代码,以分开呈现“关系的数学定义”和“关系的计算方法”。
use std::cmp::Ordering;

fn lexicographic_cmp(a: &[u8], b: &[u8]) -> Ordering {
    let common = a.len().min(b.len());
    for i in 0..common {
        match a[i].cmp(&b[i]) {
            Ordering::Equal => {}
            non_equal => return non_equal,
        }
    }
    a.len().cmp(&b.len())
}
这里比较的是字节顺序。对 Unicode 字符串,UTF-8 字节序与 Unicode 标量值顺序在合法编码上具有一致的字典序性质,但自然语言的词典排序还涉及大小写、重音、规范化和地区规则,应使用 Unicode Collation Algorithm 的实现,而不是把码点次序误称为语言学词典序。
b. 固定长度字符串的后继
若问题规定长度固定、每个位置都来自有序字母表 ,下一个字符串就是 进制加一:从末位开始,若当前字符不是最大字符就升到后继,并把右侧全部重置为最小字符;若当前字符已最大,则把它重置并继续向左进位。所有位置都溢出时不存在同长度后继。
fn next_fixed_string(digits: &mut [usize], alphabet_size: usize) -> bool {
    assert!(alphabet_size > 0);
    assert!(digits.iter().all(|&x| x < alphabet_size));

    for i in (0..digits.len()).rev() {
        if digits[i] + 1 < alphabet_size {
            digits[i] += 1;
            digits[i + 1..].fill(0);
            return true;
        }
        digits[i] = 0;
    }
    false
}
c. 下一个字典序排列
另一类常见问题不是“把字符加一”,而是在保持多重集合不变的所有排列中,求当前序列的下一个字典序排列。例如 1, 2, 3 的后继是 1, 3, 2,3, 2, 1 已是最大排列。
- 从右向左寻找最大下标
i,使a[i] < a[i + 1];其右侧必为非递增序列。 - 在后缀中从右向左寻找第一个严格大于
a[i]的元素并交换。 - 反转后缀,使它成为可行的最小升序排列。
fn next_permutation<T: Ord>(a: &mut [T]) -> bool {
    let Some(i) = (0..a.len().saturating_sub(1))
        .rev()
        .find(|&i| a[i] < a[i + 1])
    else {
        a.reverse();
        return false;
    };

    let j = (i + 1..a.len())
        .rev()
        .find(|&j| a[i] < a[j])
        .unwrap();
    a.swap(i, j);
    a[i + 1..].reverse();
    true
}i 是最靠右仍可增大的位置,所以更靠右的位置无法单独产生更小增量;与后缀中最小的较大元素交换使第一个变化位置增加得最少;最后把后缀排成升序,又使此前缀下的剩余部分最小。如果讨论所有有限字符串而不限制长度或排列集合,“立即后继”未必存在。例如在允许任意追加较小字符的字母表上,两个候选之间还可能插入别的串。因此必须先说明究竟求固定长度计数后继,还是固定多重集合的下一个排列。
2. 最长公共子串
令 dp[i][j] 为以 、 结尾的最长公共子串长度。字符相等则 dp=dp[i-1][j-1]+1,否则归零;取全局最大,时间 、滚动数组空间 。后缀树/数组可把大规模问题降到近线性。
fn longest_common_substring(a: &[u8], b: &[u8]) -> usize {
    let mut dp = vec![0; b.len() + 1];
    let mut best = 0;

    for &x in a {
        for j in (1..=b.len()).rev() {
            dp[j] = if x == b[j - 1] {
                dp[j - 1] + 1
            } else {
                0
            };
            best = best.max(dp[j]);
        }
    }
    best
}
必须从右向左更新滚动数组,否则 dp[j-1] 已是当前行值,会把同一个字符重复使用。
3. 编辑距离
令 为前缀 到 的最小代价:
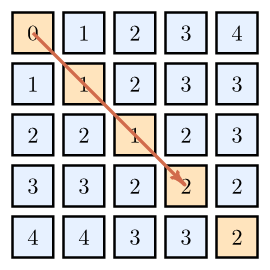
时间 、只求距离时空间可滚动为 ;若要恢复操作序列,需要保存前驱或采用 Hirschberg 式分治。不同领域还会给操作设置不同权重,或加入相邻换位得到 Damerau–Levenshtein 距离。
fn edit_distance(a: &[u8], b: &[u8]) -> usize {
    let mut previous: Vec<usize> = (0..=b.len()).collect();
    let mut current = vec![0; b.len() + 1];

    for (i, &x) in a.iter().enumerate() {
        current[0] = i + 1;
        for (j, &y) in b.iter().enumerate() {
            let deletion = previous[j + 1] + 1;
            let insertion = current[j] + 1;
            let replacement = previous[j] + usize::from(x != y);
            current[j + 1] = deletion.min(insertion).min(replacement);
        }
        std::mem::swap(&mut previous, &mut current);
    }
    previous[b.len()]
}
七、总结
短模式用朴素搜索即可;需要确定线性界用 KMP;滚动窗口候选用 Rabin–Karp;实践中长模式常受益于 Boyer–Moore 系跳跃;多模式用 Trie/AC 自动机;大量子串查询用后缀结构;相似度与对齐使用动态规划。最先确定的不是算法名字,而是字节、Unicode 标量值还是字素簇这一索引单位。
Bibliography
- [1] The Rust Project Developers, “Primitive Type str.” [Online]. Available: https://doc.rust-lang.org/std/primitive.str.html
- [2] D. E. Knuth, J. H. Morris, and V. R. Pratt, “Fast Pattern Matching in Strings,” SIAM Journal on Computing, vol. 6, no. 2, pp. 323–350, 1977, doi: 10.1137/0206024.
- [3] A. V. Aho and M. J. Corasick, “Efficient String Matching: An Aid to Bibliographic Search,” Communications of the ACM, vol. 18, no. 6, pp. 333–340, 1975, doi: 10.1145/360825.360855.