图与并查集
 Illustrated by
图用顶点集合 与边集合 表示任意成对关系,记作 。道路、依赖、通信、社交关系都可以落入同一模型,但边的方向、权重和稠密程度决定了适用算法。本章先建立存储与遍历,再让并查集、队列、堆和动态规划分别服务于连通性、拓扑序、最短路与最小生成树。
一、图的基本概念
对任意有限无向图,所有顶点度数之和满足
稠密程度不是无关紧要的形容词,它直接决定存储结构和算法复杂度应当用 还是 衡量。
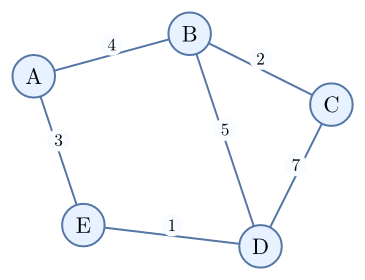
二、图的存储结构
1. 邻接矩阵
Option<W> 或无穷哨兵表示“无边”,不能把数值 0 同时承担两种语义。矩阵的行表示起点,列表示终点。有向图中 matrix[u][v] 与 matrix[v][u] 相互独立;无向图必须同时写入二者,因而矩阵关于主对角线对称。查边和更新边只需一次下标访问,为 ;寻找 的所有邻居却必须扫描完整一行,为 。无论真实边数多少,空间始终是 ,因此它适合稠密图、顶点数较小的图和本来就要反复访问任意点对的 Floyd–Warshall。
#[derive(Debug, Clone)]
pub struct MatrixGraph {
    directed: bool,
    matrix: Vec<Vec<Option<i64>>>,
}

impl MatrixGraph {
    pub fn new(vertex_count: usize, directed: bool) -> Self {
        Self {
            directed,
            matrix: vec![vec![None; vertex_count]; vertex_count],
        }
    }

    pub fn add_edge(&mut self, from: usize, to: usize, weight: i64) {
        self.matrix[from][to] = Some(weight);
        if !self.directed {
            self.matrix[to][from] = Some(weight);
        }
    }

    pub fn remove_edge(&mut self, from: usize, to: usize) {
        self.matrix[from][to] = None;
        if !self.directed {
            self.matrix[to][from] = None;
        }
    }

    pub fn weight(&self, from: usize, to: usize) -> Option<i64> {
        self.matrix[from][to]
    }

    pub fn neighbors(&self, from: usize) -> impl Iterator<Item = (usize, i64)> + '_ {
        self.matrix[from]
            .iter()
            .enumerate()
            .filter_map(|(to, weight)| weight.map(|w| (to, w)))
    }
}
这里使用 Option<i64> 把“无边”编码在类型中。若已知权值非负,也可选用一个不会参与合法计算的 INF,但所有加法都要避免溢出。矩阵的每一行都是独立 Vec;追求连续内存时可改成长度为 的单个数组,以 u*n+v 计算位置。
2. 邻接表
邻接表(adjacency list)为每个顶点建立一张出边表。外层数组的下标是顶点编号,adj[u] 中的每个记录保存终点与权值;于是遍历 的邻居只访问真实存在的 条边。对于有向图,总记录数为 ;对于无向图,每条边在两端各存一次,总记录数为 ,但空间仍为 。
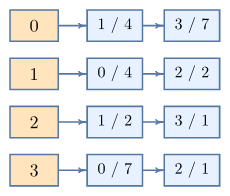
下面的实现不再把图简化成类型别名,而是把方向性、顶点数和所有基本操作封装在一起。neighbors 返回只读切片,使 DFS、Dijkstra 等算法只能观察边而不能破坏图的内部表示。
#[derive(Debug, Clone, Copy)]
pub struct Edge {
    pub to: usize,
    pub weight: i64,
}

#[derive(Debug, Clone)]
pub struct Graph {
    directed: bool,
    adj: Vec<Vec<Edge>>,
}

impl Graph {
    pub fn new(vertex_count: usize, directed: bool) -> Self {
        Self {
            directed,
            adj: vec![Vec::new(); vertex_count],
        }
    }

    pub fn vertex_count(&self) -> usize {
        self.adj.len()
    }

    pub fn add_edge(&mut self, from: usize, to: usize, weight: i64) {
        assert!(from < self.vertex_count() && to < self.vertex_count());
        self.adj[from].push(Edge { to, weight });
        if !self.directed {
            self.adj[to].push(Edge {
                to: from,
                weight,
            });
        }
    }

    pub fn neighbors(&self, vertex: usize) -> &[Edge] {
        &self.adj[vertex]
    }

    pub fn has_edge(&self, from: usize, to: usize) -> bool {
        self.adj[from].iter().any(|edge| edge.to == to)
    }

    pub fn remove_edge(&mut self, from: usize, to: usize) -> bool {
        let before = self.adj[from].len();
        self.adj[from].retain(|edge| edge.to != to);
        let removed = self.adj[from].len() != before;

        if removed && !self.directed {
            self.adj[to].retain(|edge| edge.to != from);
        }
        removed
    }
}
添加边的摊还时间为 ,枚举邻居为 ,但在未排序的表中判断或删除特定边最坏为 。若查询边是否存在远多于遍历,可把每个邻接集合换成哈希表;若边需要频繁删除且必须区分重边,则应给边分配稳定编号,单纯 retain 会删掉同端点的全部平行边。数据结构必须由操作比例决定,不能只因邻接表节省空间就认为它在所有操作上更快。
usize 作为顶点编号能让访问标记和邻接表都成为 Vec,简单而缓存友好。若外部顶点是字符串或 UUID,应先用 HashMap 映射为密集编号;这属于输入建模,不必让核心算法反复散列长键。三、图的遍历
1. 深度优先搜索(DFS)
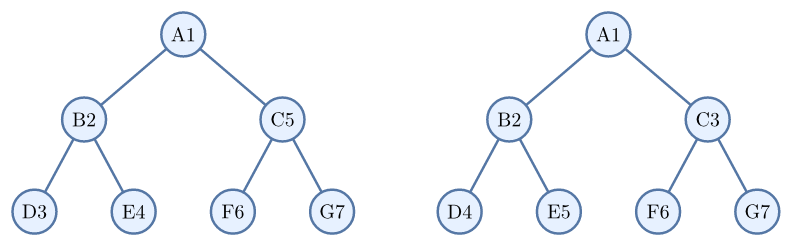
DFS 的核心不是“递归”本身,而是后进先出的探索顺序:从起点选择一条尚未访问的边不断深入,当前顶点没有新邻居时再返回最近仍有分支的顶点。递归调用栈和显式 Vec 栈只是同一策略的两种实现。
a. 具体过程
- 建立长度为 的
seen,所有位置初始为false,将起点交给 DFS。 - 顶点 一进入函数就标记并记录;不能等遍历完邻居再标记,否则环上的顶点会相互递归。
- 依次检查
u的每条出边。若终点 尚未访问,就递归处理 。 - 所有出边处理完毕后返回上一层;若要遍历非连通图,还需从每个未访问顶点重新启动一次 DFS。
b. 递归实现
fn dfs_recursive(
    graph: &Graph,
    u: usize,
    seen: &mut [bool],
    order: &mut Vec<usize>,
) {
    seen[u] = true;
    order.push(u);

    for edge in graph.neighbors(u) {
        if !seen[edge.to] {
            dfs_recursive(graph, edge.to, seen, order);
        }
    }
}
c. 不变量与复杂度
循环期间,seen[u] == true 表示顶点已经进入遍历树,而非已经退出。每个顶点至多进入一次,每条有向邻接记录至多检查一次,因此邻接表下时间为 ;seen、遍历结果及最坏递归栈均为 。递归深度可能达到 ,长链图会耗尽线程栈,大图应改用显式栈。若显式栈希望复现递归版的邻接顺序,应按逆序压入邻居;顺序不同只改变生成的 DFS 树,不改变可达性。
2. 广度优先搜索(BFS)
BFS 使用先进先出队列,让距离起点更近的顶点先扩展。它可以理解为波纹:先处理第 0 层的起点,再处理所有相距一条边的顶点,随后才轮到相距两条边的顶点。
a. 具体过程
- 将所有距离初始化为
None,设置起点距离为 0,并把起点入队。 - 取出队首 ,检查它的所有邻居 。
- 若 尚无距离,则第一次发现它:令
distance[v]=distance[u]+1,记录parent[v]=u,随后立刻入队。 - 队列为空时结束。沿
parent从终点反向追溯,可恢复一条最短路径。
“立刻标记再入队”是重要细节。若等出队才标记,同一顶点可能被同一层的多个前驱重复加入队列,不仅浪费空间,还会使父节点语义含混。
b. 完整实现
use std::collections::VecDeque;

fn bfs(graph: &Graph, start: usize) -> (Vec<Option<usize>>, Vec<Option<usize>>) {
    let n = graph.vertex_count();
    let mut distance = vec![None; n];
    let mut parent = vec![None; n];
    let mut queue = VecDeque::new();

    distance[start] = Some(0);
    queue.push_back(start);

    while let Some(u) = queue.pop_front() {
        let next_distance = distance[u].unwrap() + 1;
        for edge in graph.neighbors(u) {
            let v = edge.to;
            if distance[v].is_none() {
                distance[v] = Some(next_distance);
                parent[v] = Some(u);
                queue.push_back(v);
            }
        }
    }
    (distance, parent)
}
四、并查集
1. 并查集的基本概念与操作
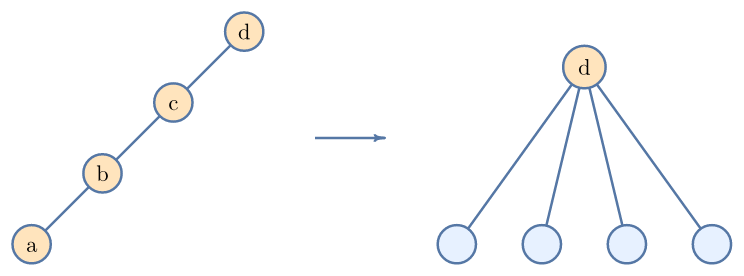
find(x) 返回 所在集合的代表元;same(a,b) 判断两个元素是否同属一集;union(a,b) 将两个集合合并。代表元只是内部选择的标识,不保证是集合中的最小值,也不描述集合内的真实路径。并查集把每个集合表示成一棵有根树,所有树共同组成森林。数组 parent[x] 指向 的父节点,根满足 parent[root] == root;从任意节点沿父指针最终都会到达唯一根。初始化时每个元素独占一个集合,因此每个节点都是根。合并时不能直接令 parent[a]=b:a、b 可能不是根,这样既会破坏优化策略,也可能把既有子树接错;必须先分别 find 两端。
它适合处理只会新增连通关系的离线或增量问题,例如 Kruskal、动态加入道路、判断冗余边。它不保存两点之间经过哪些边,也不支持高效删除和拆分;删边后的动态连通需要回滚并查集、分治离线或更复杂的动态树结构。
2. 并查集的优化策略
a. 路径压缩(Path Compression)
普通 find 逐级追父亲,链过长时一次查询可退化到 。路径压缩在找到根以后,把查询路径上的每个节点直接改指向根:第一次仍可能走得较远,但它同时为以后所有相关查询缩短道路。递归实现先求父节点的根,再在函数返回阶段写回;迭代实现则先走一遍确定根,再走第二遍重连。
b. 按秩合并(Union by Rank)
路径压缩优化查询,按秩或按大小合并则在树形成时防止它变高。按秩合并让秩较小的根指向秩较大的根,只有两根秩相等时新根的秩才增加 1;按大小合并让元素较少的根指向元素较多的根。二者不应同时维护,选择一个即可。路径压缩后,“秩”只是高度的历史上界,不再等于当前真实高度,所以压缩时不能随意减小秩。
c. 复杂度
find 与 union,同时采用路径压缩和按秩合并时,总时间为 ,均摊每次为 ;其中 是阿克曼函数的反函数。该结论是操作序列的均摊上界,不表示每一次独立 find 都有这一最坏界。只采用按大小合并时,节点每下降一层,它所在集合的规模至少翻倍;规模最多为 ,所以树高不超过 。加入路径压缩后,分析不能简单说“树几乎是常数高”便结束,而要统计父指针在整段操作中能够被改写多少次。
find 的独立最坏界。3. 并查集的实现
#[derive(Debug, Clone)]
pub struct Dsu {
    parent: Vec<usize>,
    size: Vec<usize>,
    components: usize,
}

impl Dsu {
    pub fn new(n: usize) -> Self {
        Self {
            parent: (0..n).collect(),
            size: vec![1; n],
            components: n,
        }
    }

    pub fn find(&mut self, x: usize) -> usize {
        if self.parent[x] != x {
            let root = self.find(self.parent[x]);
            self.parent[x] = root;
        }
        self.parent[x]
    }

    pub fn same(&mut self, a: usize, b: usize) -> bool {
        self.find(a) == self.find(b)
    }

    pub fn union(&mut self, a: usize, b: usize) -> bool {
        let mut root_a = self.find(a);
        let mut root_b = self.find(b);

        if root_a == root_b {
            return false;
        }
        if self.size[root_a] < self.size[root_b] {
            std::mem::swap(&mut root_a, &mut root_b);
        }

        self.parent[root_b] = root_a;
        self.size[root_a] += self.size[root_b];
        self.components -= 1;
        true
    }

    pub fn set_size(&mut self, x: usize) -> usize {
        let root = self.find(x);
        self.size[root]
    }

    pub fn component_count(&self) -> usize {
        self.components
    }
}
union 返回 bool 很有价值:true 表示原先分离的两个集合刚刚合并,false 表示这条关系是冗余的。Kruskal 正是据此决定一条边是否会成环。find 必须接收 &mut self,因为一次看似只读的查询会执行路径压缩并改写 parent;这是算法语义与 Rust 借用类型相互对应的例子。
五、拓扑排序
Kahn 算法把上述存在性证明直接变成算法:先统计每个顶点入度,将所有零入度顶点入队;每次输出一个零入度顶点,相当于从图中删除它及其出边,因此相邻顶点的入度减一。新出现的零入度顶点继续入队。最后若输出数少于 ,未删除的部分没有零入度顶点,必然含环。
fn topological_sort(graph: &[Vec<usize>]) -> Option<Vec<usize>> {
    use std::collections::VecDeque;

    let mut indegree = vec![0; graph.len()];
    for edges in graph {
        for &to in edges {
            indegree[to] += 1;
        }
    }

    let mut queue: VecDeque<usize> = (0..graph.len())
        .filter(|&u| indegree[u] == 0)
        .collect();
    let mut order = Vec::with_capacity(graph.len());

    while let Some(u) = queue.pop_front() {
        order.push(u);
        for &v in &graph[u] {
            indegree[v] -= 1;
            if indegree[v] == 0 {
                queue.push_back(v);
            }
        }
    }

    (order.len() == graph.len()).then_some(order)
}
拓扑序通常不唯一,队列改成最小堆可得到字典序最小拓扑序。任务调度还需在拓扑序上做最长路,不能把任意拓扑位置误当作最早开始时间。
六、最短路径
1. Dijkstra 算法
Dijkstra 维护从起点出发的距离上界 dist。所谓松弛,是检查经过边 的新路径是否更短:若 dist[u] + w(u,v) < dist[v],就更新 dist[v] 及其前驱。最小堆始终优先给出当前估计最小的顶点。
- 将
dist[start]设为 0,其余设为无穷,并把起点压入堆。 - 取出堆顶
(du,u)。若du != dist[u],它是旧更新遗留的陈旧项,直接跳过。 - 对 的每条出边执行松弛;成功时把新距离再次压入堆。
- 堆为空时结束;若只求某一终点,它第一次以非陈旧状态出堆时即可停止。
dist[u]=delta(s,u),此后不再改变。假设还有一条更短路径,取该路径上第一个尚未确定的顶点 及其已确定前驱 ;非负性给出 dist[x]+w(x,y) 不大于该更短路径长度,松弛后 应比 更早出堆,矛盾。负边会破坏这一步,因此不能用 Dijkstra。Rust BinaryHeap 是大顶堆,可存 Reverse((distance,vertex))。不必支持 decrease-key:直接推入新距离,出堆时若与当前 dist 不符便丢弃陈旧项。
fn dijkstra(start: usize, graph: &Graph) -> Vec<i64> {
    use std::{cmp::Reverse, collections::BinaryHeap};

    let inf = i64::MAX / 4;
    let mut distance = vec![inf; graph.vertex_count()];
    let mut heap = BinaryHeap::new();
    distance[start] = 0;
    heap.push(Reverse((0, start)));

    while let Some(Reverse((du, u))) = heap.pop() {
        if du != distance[u] {
            continue;
        }
        for edge in graph.neighbors(u) {
            assert!(edge.weight >= 0);
            let Some(next) = du.checked_add(edge.weight) else {
                continue;
            };
            if next < distance[edge.to] {
                distance[edge.to] = next;
                heap.push(Reverse((next, edge.to)));
            }
        }
    }
    distance
}
保存 parent[v]=u 可在结束后从终点反向恢复路径。不可达顶点保持 inf;若只需某个终点,它第一次以非陈旧状态出堆时即可提前停止。
2. Bellman-Ford 算法
Bellman–Ford 连续 轮扫描所有边并松弛,因为不含环的最短路至多有 条边。再扫描一轮仍能改进,说明起点可达某个负权环。时间 、空间 ,慢于 Dijkstra,但允许负边并能检测负环。加法前要先确认源距离不是无穷,且防止整数溢出。
fn bellman_ford(
    n: usize,
    edges: &[(usize, usize, i64)],
    start: usize,
) -> Option<Vec<i64>> {
    let inf = i64::MAX / 4;
    let mut distance = vec![inf; n];
    distance[start] = 0;

    for _ in 1..n {
        let mut changed = false;
        for &(u, v, weight) in edges {
            if distance[u] != inf && distance[u] + weight < distance[v] {
                distance[v] = distance[u] + weight;
                changed = true;
            }
        }
        if !changed {
            break;
        }
    }

    for &(u, v, weight) in edges {
        if distance[u] != inf && distance[u] + weight < distance[v] {
            return None;
        }
    }
    Some(distance)
}
3. Floyd-Warshall 算法
Floyd–Warshall 求所有点对最短路。令 表示只允许编号不大于 的中间点,则
用一个矩阵原地更新,三重循环的 k 必须放最外层。时间 、空间 ,适合中小型稠密图;结束后若 d[i][i]<0,存在可达负环。
fn floyd_warshall(distance: &mut [Vec<i64>]) {
    let n = distance.len();
    let inf = i64::MAX / 4;

    for k in 0..n {
        for i in 0..n {
            if distance[i][k] == inf {
                continue;
            }
            for j in 0..n {
                if distance[k][j] != inf {
                    let through_k = distance[i][k] + distance[k][j];
                    distance[i][j] = distance[i][j].min(through_k);
                }
            }
        }
    }
}
七、最小生成树
1. Prim 算法
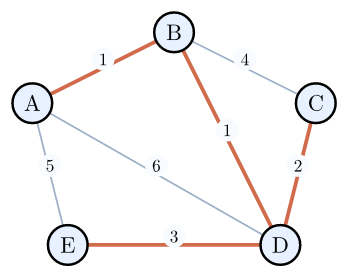
最小生成树连接无向连通图全部顶点、含 条边且总权最小。Prim 从一个顶点开始,维护跨越“树内—树外”割的最小边,每次加入其树外端点。堆实现 ,思路像 Dijkstra,但键值是接入生成树的单条边权,而非从源累加的路径长度。
fn prim(graph: &Graph) -> Option<i64> {
    use std::{cmp::Reverse, collections::BinaryHeap};

    if graph.vertex_count() == 0 {
        return Some(0);
    }

    let mut used = vec![false; graph.vertex_count()];
    let mut heap = BinaryHeap::from([Reverse((0, 0))]);
    let mut total = 0;
    let mut count = 0;

    while let Some(Reverse((weight, u))) = heap.pop() {
        if used[u] {
            continue;
        }
        used[u] = true;
        total += weight;
        count += 1;

        for edge in graph.neighbors(u) {
            if !used[edge.to] {
                heap.push(Reverse((edge.weight, edge.to)));
            }
        }
    }
    (count == graph.vertex_count()).then_some(total)
}
2. Kruskal 算法
Kruskal 按权从小到大扫描边;若一条边两端属于不同连通分量,就选中并用并查集合并,否则它会形成环而跳过。排序主导复杂度 ,并查集部分近似线性。割性质说明任意割上的最轻安全边可以进入某棵 MST;边权相同时生成树可能不唯一,但总权相同。
fn kruskal(
    n: usize,
    mut edges: Vec<(i64, usize, usize)>,
) -> Option<i64> {
    edges.sort_unstable();
    let mut dsu = Dsu::new(n);
    let mut total = 0;
    let mut selected = 0;

    for (weight, u, v) in edges {
        if dsu.union(u, v) {
            total += weight;
            selected += 1;
            if selected + 1 == n {
                break;
            }
        }
    }
    (n <= 1 || selected + 1 == n).then_some(total)
}
八、总结
| 问题 | 核心结构 | 复杂度 | 限制 |
|---|---|---|---|
| 遍历 | 栈/队列 | DFS/BFS 次序不同 | |
| 连通合并 | 并查集 | 均摊 | 不支持拆分 |
| 拓扑序 | 入度队列 | 仅 DAG | |
| 单源非负最短路 | 最小堆 | 无负边 | |
| 负边最短路 | 边松弛 | 可检测负环 | |
| MST | 堆或并查集 | 约 | 无向连通图 |
Rust、C++、Java 标准库都提供数组、队列、堆和集合,却没有统一的 Graph 或并查集标准类型;图的顶点、边属性和更新模型差异过大,项目通常自行组合这些基础容器或采用专门图库。
Bibliography
- [1] R. E. Tarjan, “Efficiency of a Good But Not Linear Set Union Algorithm,” Journal of the ACM, vol. 22, no. 2, pp. 215–225, 1975, doi: 10.1145/321879.321884.
- [2] E. W. Dijkstra, “A Note on Two Problems in Connexion with Graphs,” Numerische Mathematik, vol. 1, pp. 269–271, 1959, doi: 10.1007/BF01386390.