特征提取与图像拼接
 Illustrated by
分割把图像变成边界、区域或目标掩膜,特征提取则把这些像素集合进一步压缩为便于比较的数值描述。轮廓可以编码为方向序列,角点由局部灰度在两个方向上的变化确定,稳定区域通过阈值变化追踪,局部纹理则可组织成具有尺度和方向的描述向量。图像拼接正是这些思想的综合应用:先在不同图像中找到可重复定位的局部特征,再由匹配关系估计视图之间的几何变换。[1]
特征的价值取决于可重复性:同一个物理点在视角、尺度、旋转或曝光改变后,能否被再次检出并给出相近的局部描述。可重复性越差,后续匹配就越依赖剔除误匹配来补救。这正解释了为何把检测器、描述子、匹配器与几何模型分开:前两者负责“能在不同视图里认出同一处”,后两者负责“判断哪些对应可信、能否由同一成像关系解释”。
特征检测器回答“位置在哪里”,描述子回答“该位置周围是什么”,匹配器建立跨图像对应,几何模型判断这些对应能否由同一个成像关系解释。本章依次讨论轮廓特征、局部特征和完整的多图拼接流程。
一、链码
轮廓若保存为绝对坐标序列,不但占用空间,而且整体平移后每个坐标都会改变。链码改为记录相邻边界点之间的移动方向:起点给出绝对位置,之后只保存一步步如何移动,从而把二维坐标序列转化为有限字母表上的方向序列。
1. 弗里曼链码
设有序边界点为 ,相邻点满足指定的 4 邻接或 8 邻接关系。选定方向编号映射 后,边界的弗里曼链码为
四方向编码通常取右、上、左、下为 ;八方向编码再插入四个对角方向,使方向角每次增加 。编码表并非唯一,但编码、解码和比较必须使用同一约定。四方向链码只能以水平、竖直台阶逼近斜边,八方向链码可以用对角步长给出更紧凑的表示。
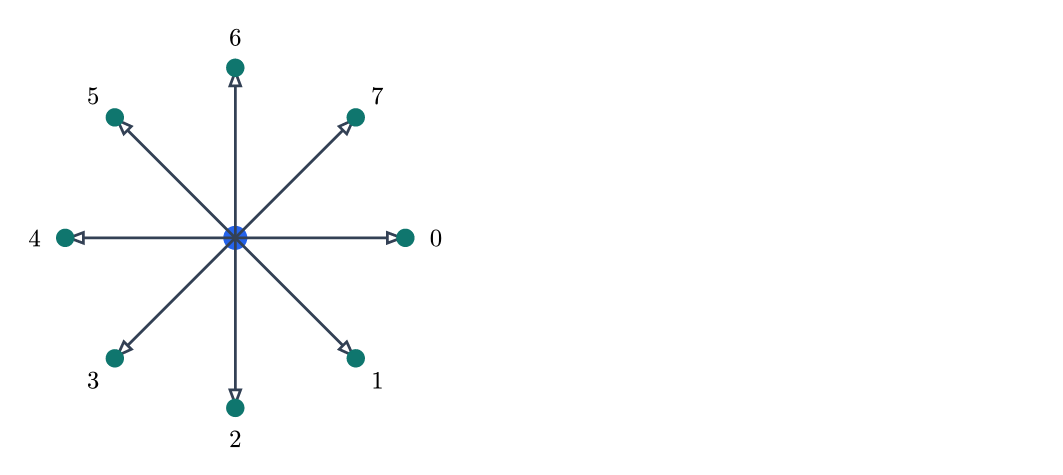
方向表确定了“坐标差到符号”的翻译规则。例如图像坐标中 轴向下,所以右上移动的坐标差为 ,在图示约定下编码为 1;向下移动的坐标差为 ,编码为 6。若采用数学坐标系而让 轴向上,同一编号表对应的坐标差也必须随之调整。
计算过程分为三步:先取得单像素宽且顺序确定的边界;再固定起点和遍历方向,例如从最上方最左点开始顺时针行走;最后对每对相邻点求坐标差并查询方向表。OpenCV 必须使用 CHAIN_APPROX_NONE 保留逐像素边界,否则折线压缩会跳过中间步。
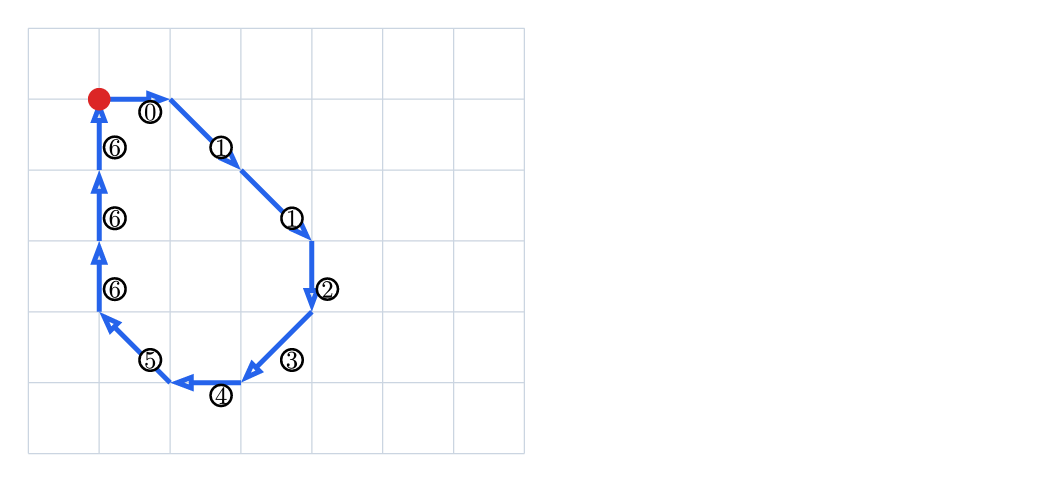
图示也说明为什么起点和方向属于编码约定:若红点沿同一轮廓移动,得到的是原序列的循环移位;若箭头整体反向,每一步都要替换为相反方向的编号,而且顺序也随之逆转。轮廓本身没有改变,字符串表示却不同。
import cv2
import numpy as np

DIR8 = {
    (1, 0): 0,
    (1, -1): 1,
    (0, -1): 2,
    (-1, -1): 3,
    (-1, 0): 4,
    (-1, 1): 5,
    (0, 1): 6,
    (1, 1): 7,
}

def freeman_chain(contour):
    points = contour.reshape(-1, 2)
    codes = []
    for i in range(len(points)):
        current = points[i]
        following = points[(i + 1) % len(points)]
        dx, dy = (following - current).tolist()
        step = (int(np.sign(dx)), int(np.sign(dy)))
        codes.append(DIR8[step])
    return points[0], codes

binary = cv2.imread("shape.png", cv2.IMREAD_GRAYSCALE)
contours, _ = cv2.findContours(
    binary,
    cv2.RETR_EXTERNAL,
    cv2.CHAIN_APPROX_NONE,
)
start, chain = freeman_chain(max(contours, key=cv2.contourArea))2. 斜率链码
弗里曼链码描述逐像素移动,边界稍有锯齿便会快速交替方向。斜率链码先把轮廓近似为若干线段,再记录每段的方向或斜率。它牺牲部分像素级细节,却更接近“这段边界总体朝哪个方向延伸”的几何意义。
设轮廓经折线逼近得到顶点 。第 段方向角为
把角度区间量化为 个方向,所得序列
实现时先用 cv2.approxPolyDP 做折线逼近。误差阈值过小,编码仍充满局部抖动;阈值过大,真正的凹角和短边会消失。常把阈值写成轮廓周长的一小部分,使它随目标尺寸缩放。
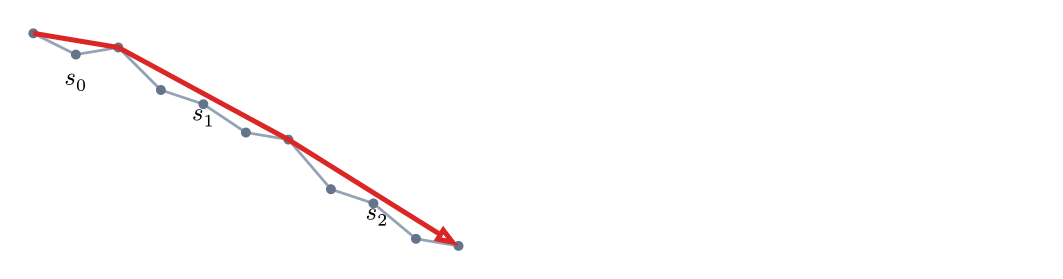
因此,斜率链码的一个符号通常概括多个像素步。它比弗里曼链码短,也更能抑制一两个像素的锯齿;代价是结果依赖折线逼近误差,并且无法从编码无损恢复原始像素边界。
def slope_chain(contour, directions=16, epsilon_ratio=0.01):
    perimeter = cv2.arcLength(contour, closed=True)
    polygon = cv2.approxPolyDP(
        contour,
        epsilon_ratio * perimeter,
        closed=True,
    ).reshape(-1, 2)
    codes = []
    for i in range(len(polygon)):
        x0, y0 = polygon[i]
        x1, y1 = polygon[(i + 1) % len(polygon)]
        angle = np.arctan2(y1 - y0, x1 - x0) % (2 * np.pi)
        codes.append(int(directions * angle / (2 * np.pi)))
    return polygon, codes
3. 长度、曲率与形状数
八方向链码中,水平或竖直一步长度为 1,对角一步长度为 ,故轮廓长度常估计为
其中 、 分别是偶数方向码和奇数方向码的数量。该估计仍受网格方向影响;高精度周长测量应使用亚像素轮廓或校正估计。
方向的一阶差分描述转弯。对 方向编码,
称为差分链码。连续直行时差分为 0,转弯时差分非零;若使用带符号的最短角差,还能近似离散曲率,单位弧长内方向改变越快,曲率绝对值越大。
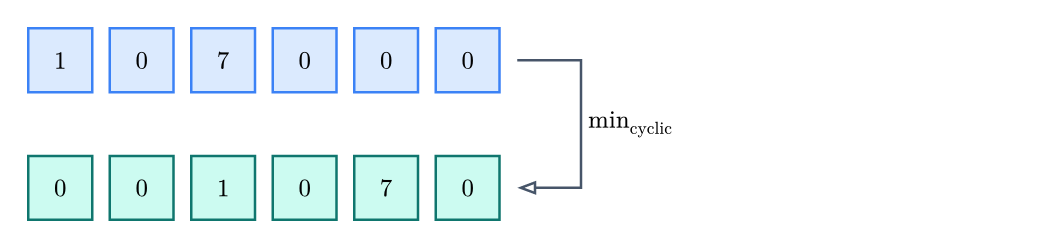
差分消除了整体旋转造成的方向码常量偏移,取最小循环移位又消除了起点差异,因此形状数对平移、链码起点和量化范围内的旋转具有不变性。但缩放会改变采样点数量,噪声会改变局部差分,比较前仍常需平滑和等弧长重采样。
二、哈里斯-斯蒂芬斯角点检测
边缘上的窗口沿边缘方向移动时变化很小,垂直边缘移动时变化很大;角点附近无论向哪个方向移动,窗口内容都会明显改变。哈里斯方法把这一观察写成窗口的自相似误差。[2]
设窗口权重为 ,窗口平移 后的平方差为
对小位移作一阶泰勒展开,
代回并整理得到
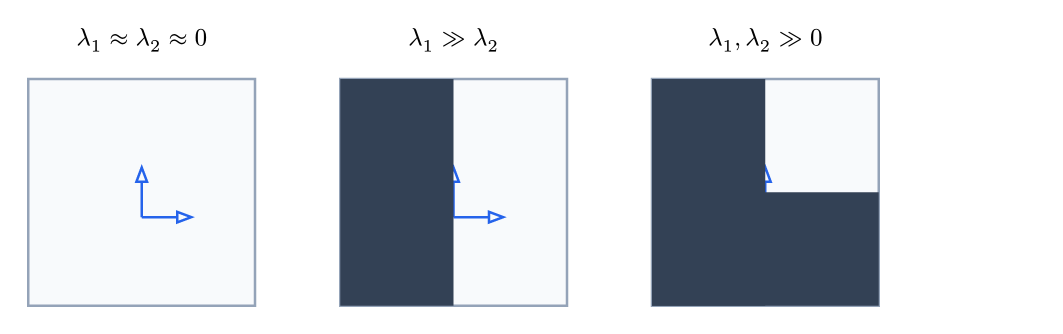
的特征值 描述局部灰度沿两个主方向的变化。两者都小是平坦区域;一大一小是边缘;两者都大时,窗口沿任何方向移动都会产生明显误差,因而是角点。
定义
常取 0.04 到 0.06。程序不能把所有超过阈值的像素都当成独立角点,因为一个真实角点周围会形成一片高响应;完整流程还要做非极大值抑制,需要更高定位精度时再做亚像素细化。
image = cv2.imread("scene.jpg")
gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
gray32 = np.float32(gray) / 255.0
response = cv2.cornerHarris(gray32, 2, 3, 0.04)

dilated = cv2.dilate(response, None)
corners = (response == dilated) & (
    response > 0.01 * response.max()
)
marked = image.copy()
marked[corners] = (0, 0, 255)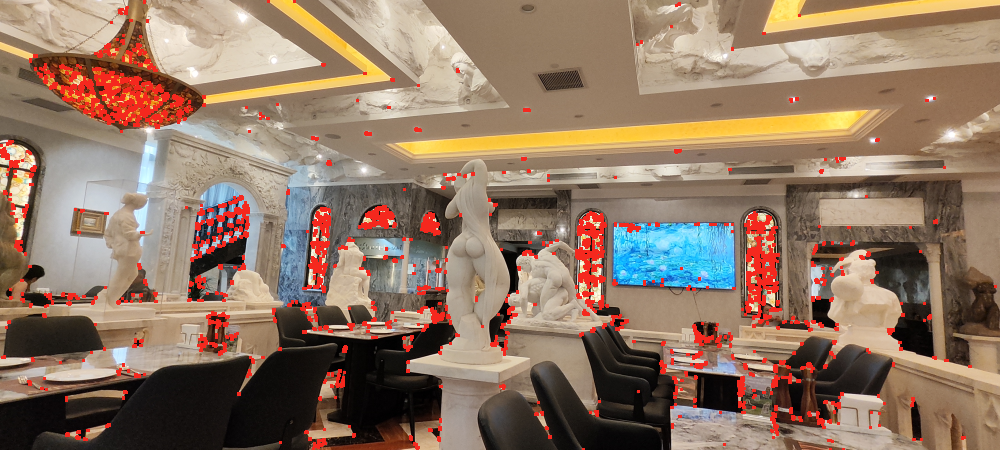
三、最大稳定极值区域
最大稳定极值区域考察阈值变化时连通区域是否稳定。把灰度阈值从黑到白逐渐提高,低于阈值的像素不断加入,连通分量会出现、增长并合并。如果某个分量在一段阈值范围内面积几乎不变,它通常对应具有稳定内部灰度的物体区域。[3]
令 表示阈值 下包含关系连续的一族极值区域。给定步长 ,面积相对变化率为
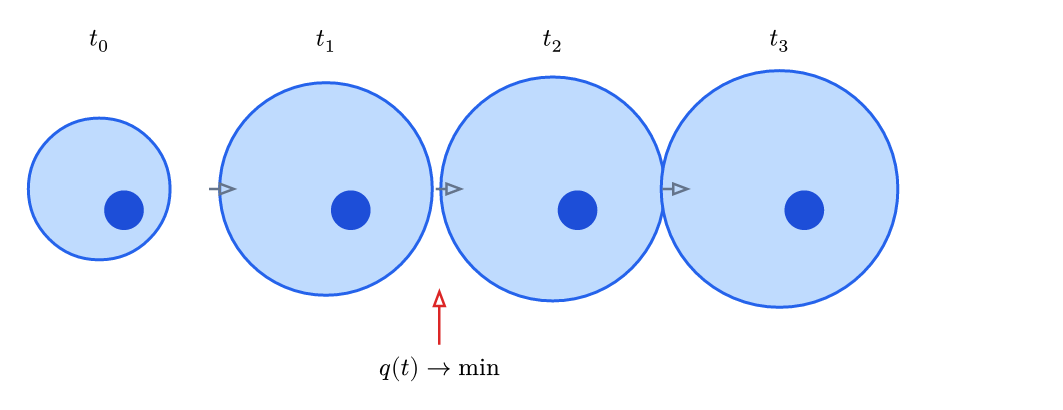
“最大稳定”不是面积最大,而是相对于阈值变化最稳定。算法按灰度顺序加入像素并维护连通分量树,沿每条树枝追踪面积变化,寻找变化率局部极小,再删除过小、过大、变化过快或高度重复的区域。对反相图像重复检测,可以同时取得亮极值区域。
MSER 对单调灰度变换稳定,因为变换会改变阈值数值,却不会改变像素灰度排序。它适合文字、标牌和近似均匀的斑块;纹理区域、模糊边界和大面积渐变则可能缺少稳定平台。
gray = cv2.imread("scene.jpg", cv2.IMREAD_GRAYSCALE)
mser = cv2.MSER_create(5, 80, 9000)
regions, boxes = mser.detectRegions(gray)

view = cv2.cvtColor(gray, cv2.COLOR_GRAY2BGR)
for region in regions:
    hull = cv2.convexHull(region.reshape(-1, 1, 2))
    cv2.polylines(view, [hull], True, (0, 255, 0), 1)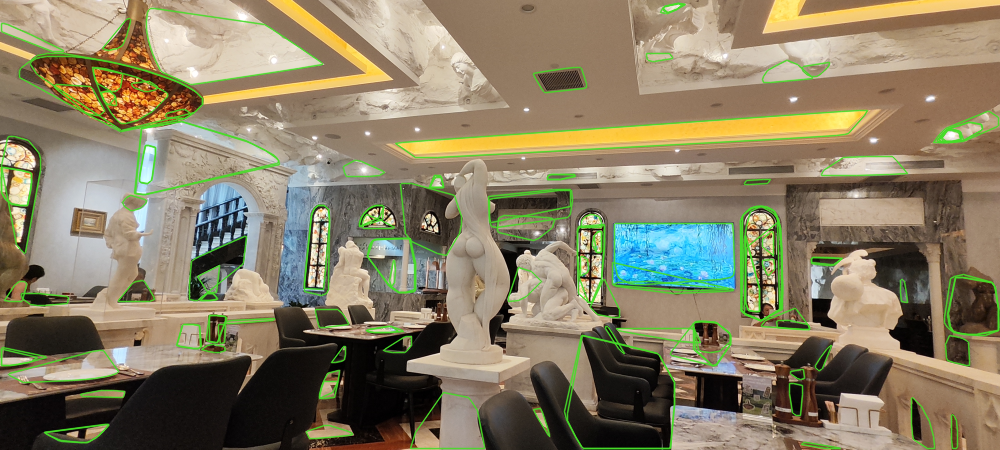
四、尺度不变特征变换(SIFT)
拼接图像可能具有不同缩放、旋转、曝光和局部视角。只检测角点坐标还不够,必须为每个点构造可比较的局部描述。SIFT 把检测尺度、主方向和梯度直方图结合起来,使关键点在缩放、旋转后仍具有较稳定的表示。[4]
1. 尺度空间与关键点检测
图像 的高斯尺度空间为
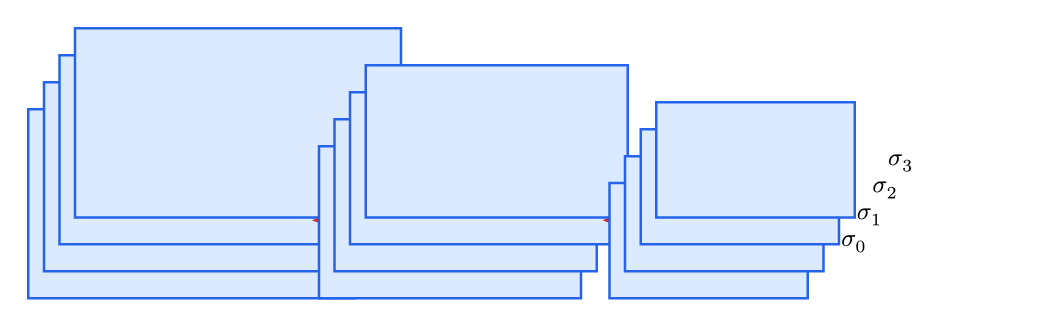
若只在原图上寻找极值,同一物体缩小后角点邻域也会缩小,检测结果便会改变。SIFT 把尺度作为第三个坐标,在 空间寻找结构。为降低计算量,它使用相邻高斯图像之差
近似尺度归一化的高斯拉普拉斯。每个 DoG 样本与同层八邻居、上一层九邻居、下一层九邻居比较,严格极大或极小者成为候选点。
尺度按组组织:每组内逐渐增大 ,完成若干层后把图像下采样一半进入下一组。候选点还要通过三维二次函数插值细化位置和尺度;低对比度点被删除,沿边缘却定位不稳定的点依据 Hessian 主曲率比删除。
2. 方向分配与描述子
在关键点尺度对应的高斯图像上计算梯度幅值和方向:
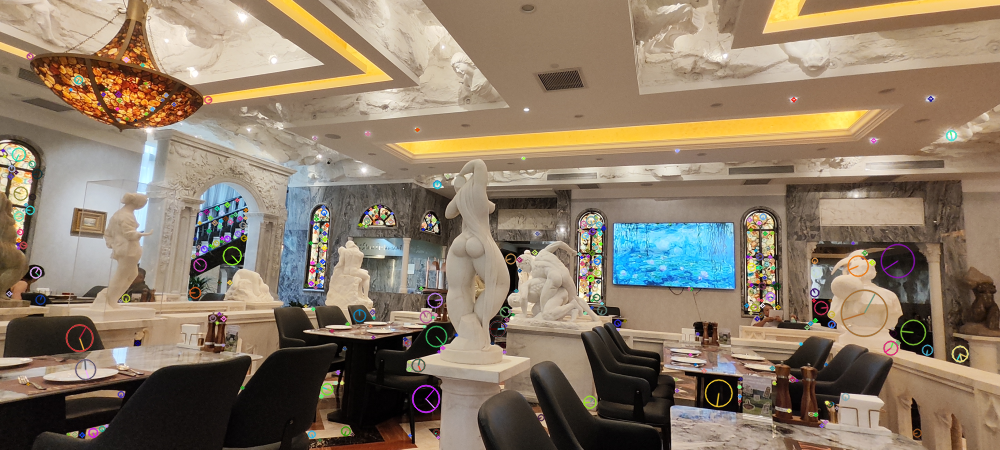
将加权梯度累积到 36 个方向箱,最高峰给出主方向。描述邻域随主方向旋转,因此图像整体旋转会被局部坐标系抵消。
归一化削弱整体对比度倍乘的影响。经典实现还把过大的分量截断到 0.2 后再次归一化,以免少数强梯度支配向量。强透视变形、重复纹理和动态物体仍可能产生歧义。
image = cv2.imread("scene.jpg")
gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
sift = cv2.SIFT_create(nfeatures=2000)
keypoints, descriptors = sift.detectAndCompute(gray, None)

view = cv2.drawKeypoints(
    image,
    keypoints,
    None,
    flags=cv2.DRAW_MATCHES_FLAGS_DRAW_RICH_KEYPOINTS,
)
3. 描述子匹配
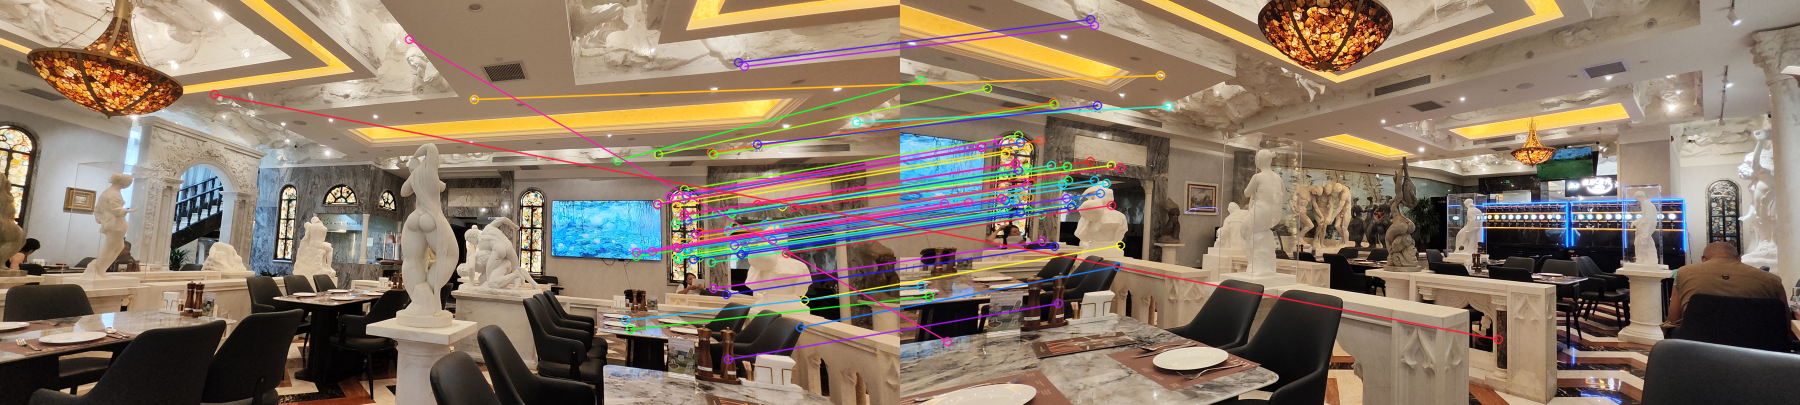
两幅图的 SIFT 描述子用欧氏距离比较。对第一幅图的每个描述子,在第二幅图寻找最近和次近候选。若两者距离接近,说明局部纹理有歧义;Lowe 比值检验只接受
其中 常取 0.7 到 0.8。它只排除描述空间中的歧义,不能保证匹配符合整体几何,之后仍须由 RANSAC 剔除离群点。
matcher = cv2.BFMatcher(cv2.NORM_L2)
pairs = matcher.knnMatch(desc1, desc2, k=2)
good = [
    nearest
    for nearest, second in pairs
    if nearest.distance < 0.75 * second.distance
]
五、图像拼接
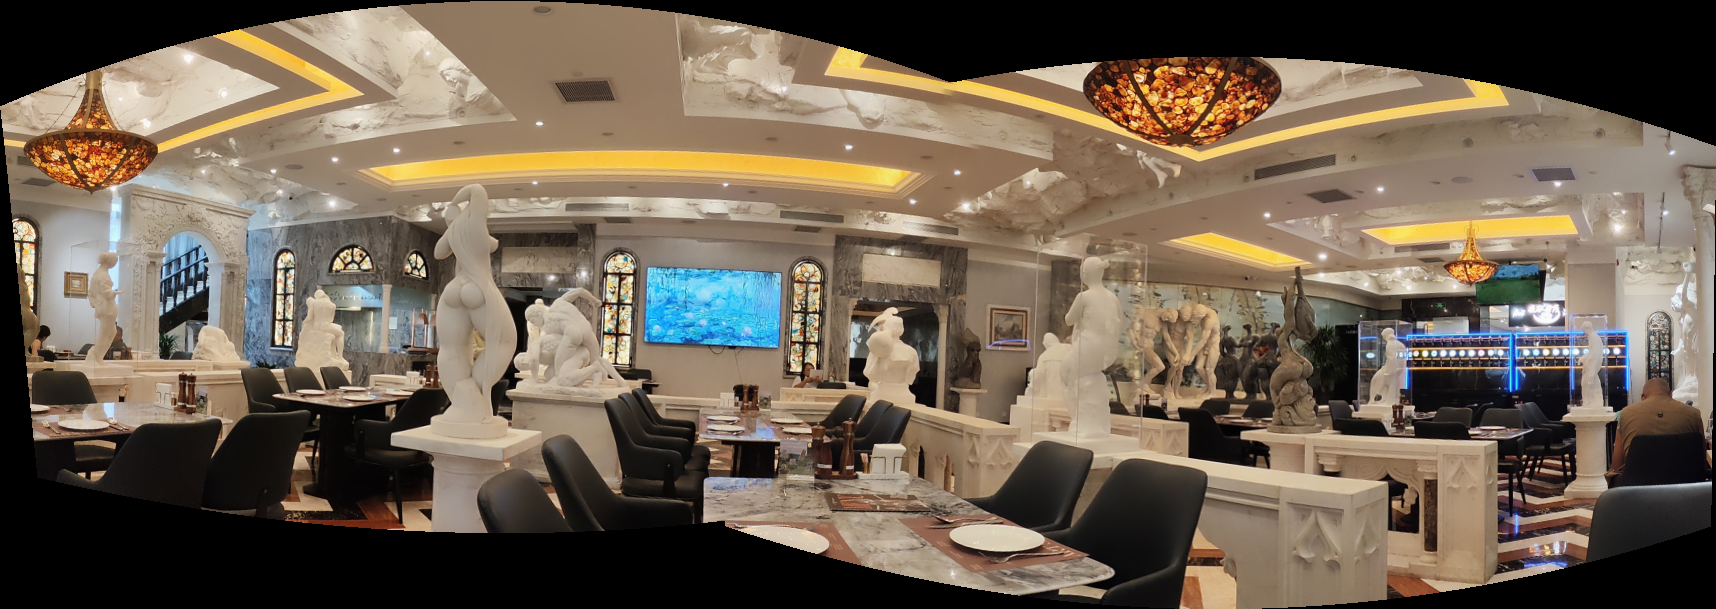
图像拼接把同一场景的多个视图映射到公共坐标系。可靠流程依次完成特征提取、候选匹配、鲁棒几何估计、坐标变换、画布计算和重叠区融合。每个阶段都应检查匹配数量、内点比例和重投影误差。
1. 单应性矩阵
平面射影变换由非奇异 矩阵 表示。对齐次坐标 ,
展开后,
每对点提供两个约束,理论上至少需要四对一般位置的对应点;若四点近乎共线,方程会病态。单应性适用条件很明确:它把同一个平面上的点一一对应,或等价地描述相机绕光心旋转时的纯射影变换。若相机发生明显平移且场景有较大深度差,近景与远景会产生不同视差,单个 无法同时对齐全部像素;此时应改做更一般的多视几何或先近似分平面。选模型不是因为“单应性看起来简单”,而是因为场景确实满足其前提。
2. RANSAC 鲁棒估计
比值检验后仍有错误匹配,普通最小二乘会被少量离群点严重拉偏。RANSAC 反复抽取最小样本,寻找能解释最多对应点的模型。[5]
从全部匹配随机抽取四对不退化的点,计算候选单应性 。
用 投影所有源点,计算投影位置与实际匹配点之间的重投影误差。
将误差不超过阈值 的匹配记为内点,记录内点最多的模型。
重复抽样,直到达到迭代上限或所需成功概率。
用最优内点集合重新估计 ,避免只用四对点的粗糙模型。
设单次抽取 个样本,内点比例为 ,希望至少一次抽到全内点样本的概率不低于 ,则独立抽样次数满足
src = np.float32(
    [keypoints1[m.queryIdx].pt for m in good]
).reshape(-1, 1, 2)
dst = np.float32(
    [keypoints2[m.trainIdx].pt for m in good]
).reshape(-1, 1, 2)

homography, inliers = cv2.findHomography(
    src,
    dst,
    cv2.RANSAC,
    4.0,
    confidence=0.995,
)
3. 变形、画布与融合
求得 后,不能直接把源图变形到目标图原尺寸,因为变换后的角点可能落在负坐标或超出右下边界。应先变换源图四角,与目标图四角共同求包围盒,再增加平移矩阵 把最小坐标移到画布原点,最终使用 执行透视变形。
重叠区若直接被后一幅图覆盖,会形成明显接缝。最简单的羽化融合根据像素到各自有效区边界的距离构造权重:
曝光差较大时先做增益补偿;具有运动目标或小量视差时需要寻找避开高差异区的接缝;多频段融合则在不同尺度分别融合低频亮度和高频细节。
4. 多幅图像的完整实现
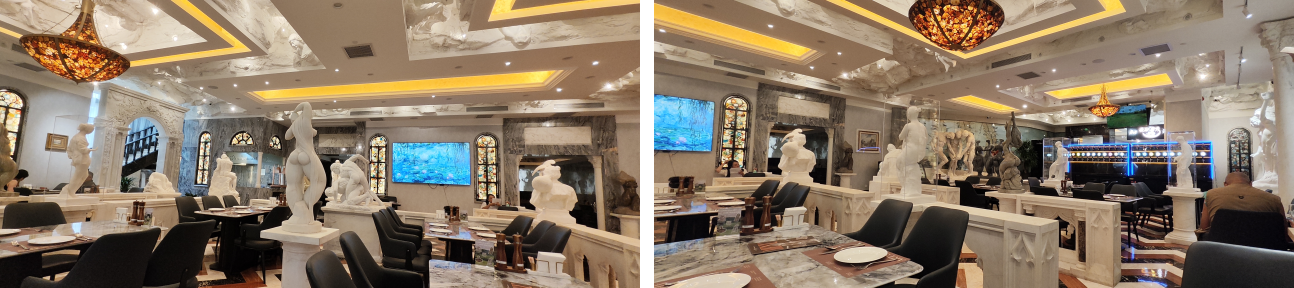
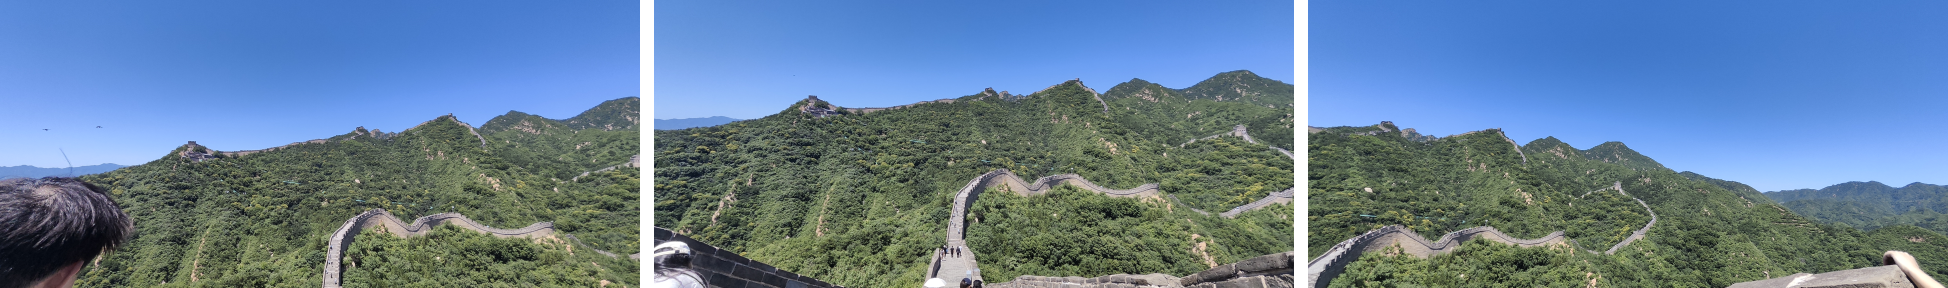
多图拼接不能简单地把每幅图独立映射到第一幅图,否则匹配误差会沿图像链累积成漂移。工程系统先建立图像匹配图,选择连接可靠的参考图,联合优化相机参数,再统一变形和融合。下面的代码接受任意不少于两幅的输入;inspect_pair 显式检查每对相邻图能否产生足够的 RANSAC 内点,Stitcher 再完成匹配图建立、相机估计、束调整、变形、曝光补偿、接缝搜索和融合。
from pathlib import Path

import cv2
import numpy as np

def read_color(path):
    data = np.fromfile(path, dtype=np.uint8)
    image = cv2.imdecode(data, cv2.IMREAD_COLOR)
    if image is None:
        raise ValueError(f"无法读取图像:{path}")
    return image

def inspect_pair(left, right, ratio=0.75):
    sift = cv2.SIFT_create(nfeatures=3000)
    gray1 = cv2.cvtColor(left, cv2.COLOR_BGR2GRAY)
    gray2 = cv2.cvtColor(right, cv2.COLOR_BGR2GRAY)
    kp1, desc1 = sift.detectAndCompute(gray1, None)
    kp2, desc2 = sift.detectAndCompute(gray2, None)

    matcher = cv2.BFMatcher(cv2.NORM_L2)
    pairs = matcher.knnMatch(desc1, desc2, k=2)
    good = [
        nearest
        for nearest, second in pairs
        if nearest.distance < ratio * second.distance
    ]
    if len(good) < 4:
        raise RuntimeError("可靠匹配不足")

    src = np.float32(
        [kp1[m.queryIdx].pt for m in good]
    ).reshape(-1, 1, 2)
    dst = np.float32(
        [kp2[m.trainIdx].pt for m in good]
    ).reshape(-1, 1, 2)
    homography, mask = cv2.findHomography(
        src,
        dst,
        cv2.RANSAC,
        4.0,
    )
    return homography, mask

def stitch_many(paths, output_path):
    if len(paths) < 2:
        raise ValueError("至少需要两幅图像")
    images = [read_color(Path(path)) for path in paths]

    for left, right in zip(images, images[1:]):
        homography, mask = inspect_pair(left, right)
        if homography is None or int(mask.sum()) < 10:
            raise RuntimeError("相邻图像的几何内点不足")

    stitcher = cv2.Stitcher_create(cv2.Stitcher_PANORAMA)
    stitcher.setPanoConfidenceThresh(0.6)
    status, panorama = stitcher.stitch(images)
    if status != cv2.Stitcher_OK:
        raise RuntimeError(f"拼接失败,状态码为 {status}")

    ok, encoded = cv2.imencode(".png", panorama)
    if not ok:
        raise RuntimeError("结果编码失败")
    encoded.tofile(output_path)
    return panorama

stitch_many(
    ["21.jpg", "22.jpg", "23.jpg"],
    "panorama.png",
)
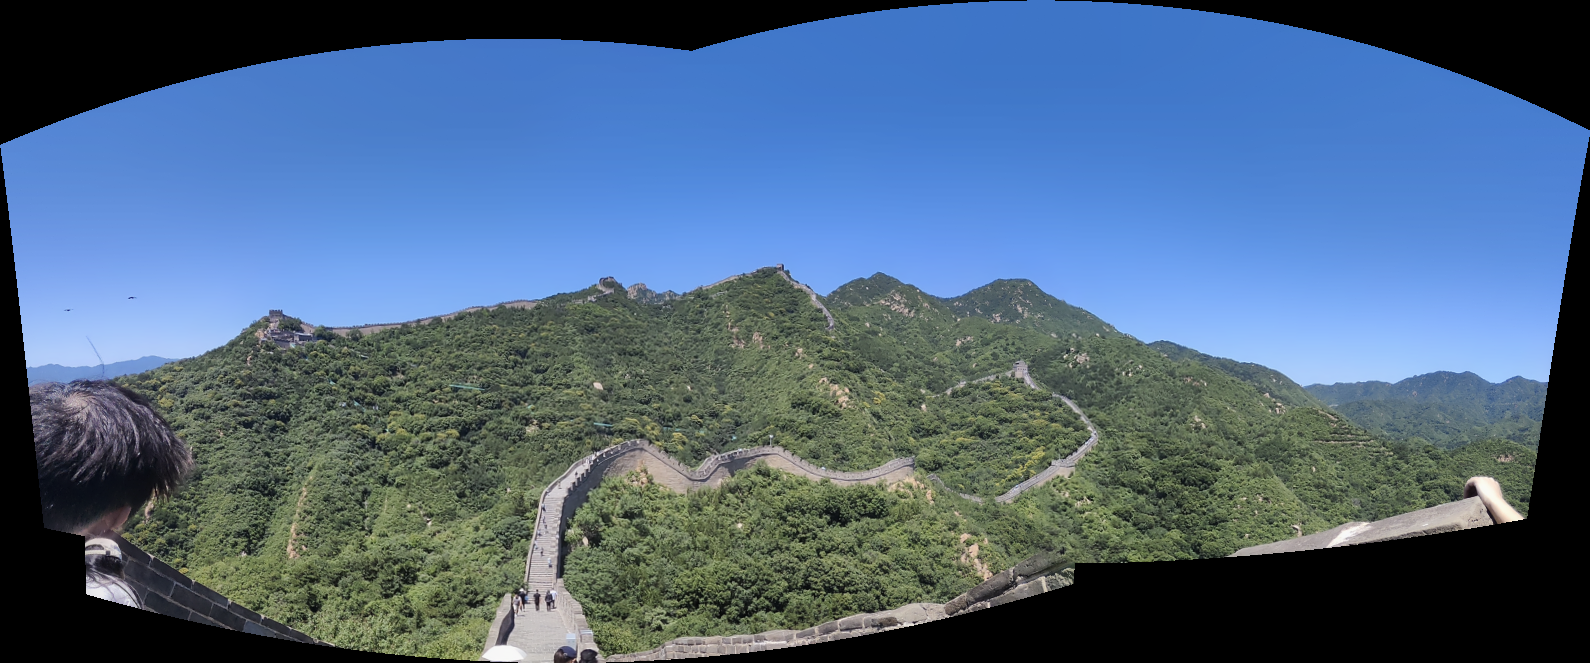
5. 失败条件与诊断
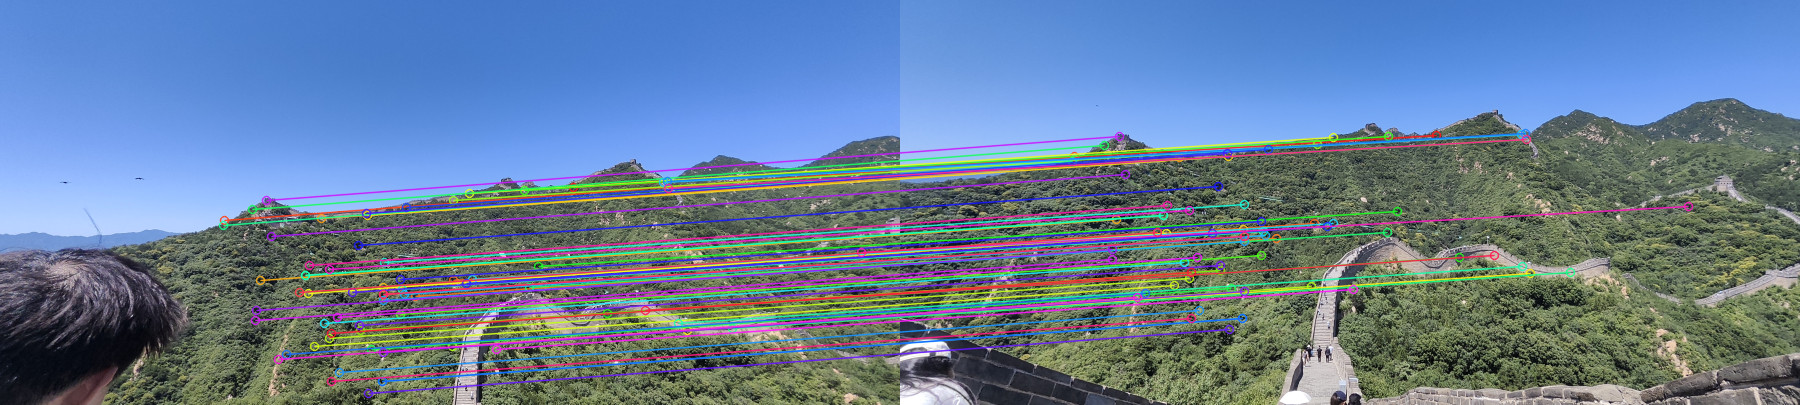
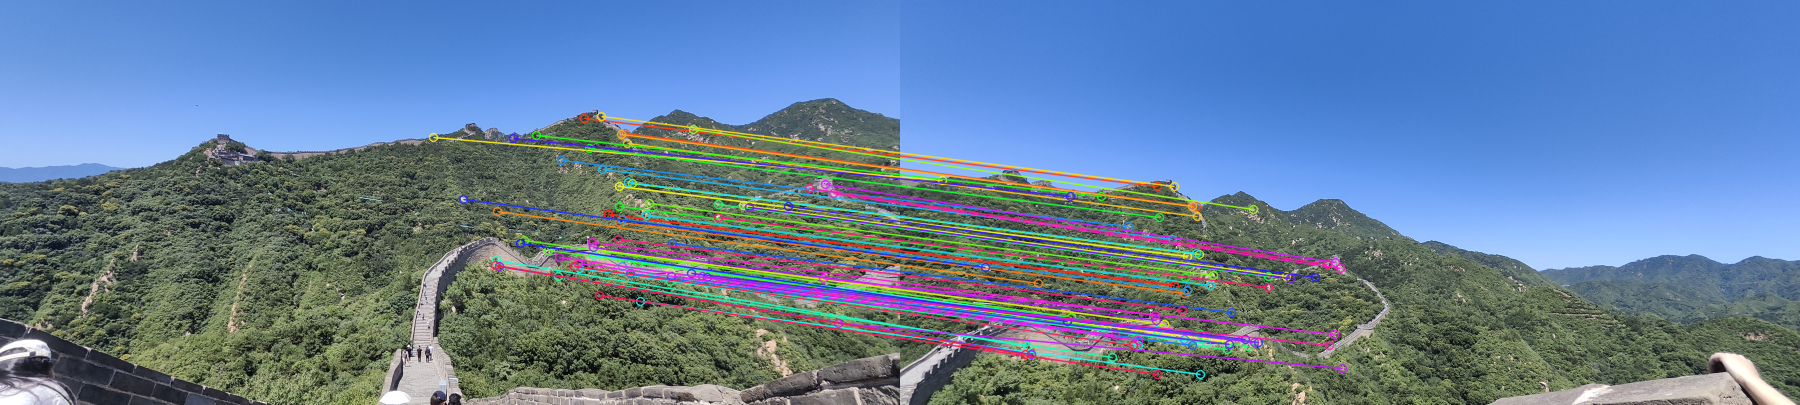
拼接失败时应沿处理链逐段判断。首先检查相邻图是否有足够重叠和二维分布良好的关键点;匹配若集中在一条线或很小区域,单应性会不稳定。其次查看 RANSAC 内点连线是否保持一致方向,内点率过低通常意味着重复纹理或比值阈值过松。再次检查单应性假设:近景栏杆与远景建筑同时出现时,视差会让两者无法同时对齐。最后才处理曝光差、暗角、接缝和运动物体等融合问题。
image[y, x] 得到 [B, G, R]。SIFT 通常在灰度图上计算,不受此顺序影响,但绘制自定义颜色、转到 Matplotlib 或手工融合彩色通道时必须显式转换。References
- [1] R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed. Pearson, 2018.
- [2] C. Harris and M. Stephens, “A Combined Corner and Edge Detector,” pp. 147–151, 1988.
- [3] J. Matas, O. Chum, M. Urban, and T. Pajdla, “Robust Wide-Baseline Stereo from Maximally Stable Extremal Regions,” Image and Vision Computing, vol. 22, no. 10, pp. 761–767, 2004.
- [4] D. G. Lowe, “Distinctive Image Features from Scale-Invariant Keypoints,” International Journal of Computer Vision, vol. 60, no. 2, pp. 91–110, 2004.
- [5] M. A. Fischler and R. C. Bolles, “Random Sample Consensus: A Paradigm for Model Fitting with Applications to Image Analysis and Automated Cartography,” Communications of the ACM, vol. 24, no. 6, pp. 381–395, 1981.