傅里叶变换
 Illustrated by
一幅图像可以按像素位置描述,也可以按空间变化的快慢描述。大片缓慢变化的背景对应低空间频率,密集条纹、边缘和细小纹理包含较高空间频率。傅里叶变换所做的事情,是把图像在复指数基底上展开:空间域中的每个像素共同决定各频率系数,而每个频率系数又同时携带振幅与相位。[1]
本章首先从一维傅里叶级数过渡到连续傅里叶变换和 DFT,再把结论推广到二维图像,最后解释 FFT 为何能把 DFT 的计算量从平方级降到近线性对数级。这里集中建立后续频域滤波所需的数学与算法。除另加说明,本章统一采用角频率(弧度/单位)约定,虚数单位记作 ,正变换指数为 ;这一约定在进入二维与频域滤波后不再重复声明。关于广义函数、连续时间系统和采样的更完整讨论,可参阅连续时间傅里叶与单位冲激函数与卷积。
一、单变量傅里叶变换
1. 傅里叶级数与冲激函数
设 以 为周期,基本角频率为 。在适当的可积条件下,它可以展开为
其中
这些复指数函数在任意完整周期上彼此正交。计算 的过程,可以理解为用 与第 个基函数做内积:若信号中含有相同频率与方向的复指数,正负相位会相干累加;不匹配的周期振荡则在积分中相互抵消。 因而描述第 个谐波的复振幅。
傅里叶级数只在离散频率 上取值。为了把这种“线谱”表示得像一个连续频率函数,可以在每个谱线位置放置冲激。
狄拉克冲激 不是普通函数,而是满足
以及筛选性质
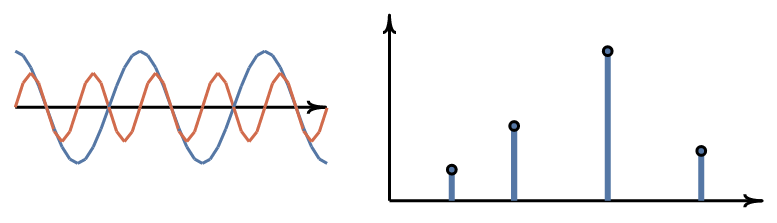
一个周期信号的频谱可以写成一列位于 的冲激。时域越周期,频域越离散;反过来,单个复指数在频域只留下一个冲激。这一对偶关系解释了为什么不能把连续频谱曲线与周期信号的离散谱线混为一谈。
2. 连续傅里叶变换
将周期 不断增大,基本频率间隔 不断缩小。原来的求和
逐渐成为关于连续角频率 的积分。为了让极限保持有限,把 看作频谱函数在 的取值,便得到连续傅里叶变换对。
对绝对可积函数 ,本章采用角频率约定
不同教材可能把 分配到指数或归一化系数中。约定改变不会改变理论本质,但同一次推导必须始终使用同一约定。本章用 表示弧度频率,因此正变换指数为 ,反变换前有 。
复频谱可写为
是幅度谱,描述该频率分量的强度; 是相位谱,描述各分量在空间或时间上的相对对齐。只看幅度谱会丢掉重建结构所需的位置信息,因此频谱绝不等同于一张“高低频能量图”。
傅里叶变换还把卷积转化为乘法。
两个函数 、 的卷积定义为
若 与 的傅里叶变换分别为 与 ,则
并且
证明.将卷积定义代入正变换并交换积分次序:
卷积定理让一个看似需要不断滑动、积分的运算,变成频域逐点相乘。不过连续结论移到有限离散数组后会变成循环卷积;如何避免首尾交叠,必须等二维 DFT 的周期性建立后再处理。
3. 离散傅里叶变换
计算机保存的是有限样本 。DFT 不直接等于“对连续变换做采样”,而是有限维复向量上的可逆线性变换;它隐含地把这 个样本视为一个周期。
令
长度为 的 DFT 与逆变换定义为
是单位圆上的 次单位根。频率索引每增加 ,指数就多转整数圈,所以 ;输入也被解释为 。这正是 DFT 的周期性来源。本章定义的这个 会在二维 DFT、逐次加倍法与蝶形因子中反复出现,是后续所有分析共享的底层对象。
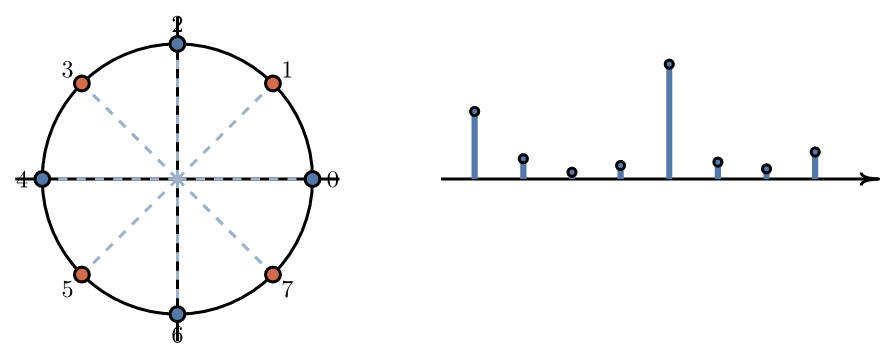
把所有系数写成矩阵形式,DFT 矩阵第 项为 。单位根的正交性给出
所以逆矩阵只需共轭并乘 。这也说明 DFT 不丢失信息;丢失通常发生在修改系数、舍弃相位或量化输出时。
朴素实现按定义计算每一个 :
import numpy as np

def dft_naive(x: np.ndarray) -> np.ndarray:
    x = np.asarray(x, dtype=np.complex128)
    n = x.size
    result = np.empty(n, dtype=np.complex128)

    for k in range(n):
        total = 0.0j
        for sample in range(n):
            angle = -2.0 * np.pi * k * sample / n
            total += x[sample] * np.exp(1j * angle)
        result[k] = total
    return result

def idft_naive(spectrum: np.ndarray) -> np.ndarray:
    spectrum = np.asarray(spectrum, dtype=np.complex128)
    n = spectrum.size
    return np.conjugate(dft_naive(np.conjugate(spectrum))) / n
外层有 个频率,内层累加 个样本,时间复杂度为 ,另需 输出空间。代码的价值是逐项对应定义;实际大数组应使用 FFT。
二、二变量傅里叶变换
1. 二维连续傅里叶变换对
图像是二变量函数 。二维复指数可以看成一个方向和空间周期确定的平面波,因此二维变换把图像分解为不同方向、不同空间频率的平面波。
采用角空间频率 时,
频率点 的向量方向是灰度变化最快的法向方向,与条纹延伸方向垂直;向量长度控制空间振荡速度。原点 对应常量基函数,系数 是图像积分,因此称为直流分量。
2. 二维离散傅里叶变换(DFT 与 IDFT)
沿用基础篇的坐标约定:图像高为 、宽为 , 是水平坐标, 是垂直坐标;、 分别是对应方向的频率索引。二维 DFT 为
逆变换为
数学坐标写作 ,NumPy 数组却按 [row, column] 排列,所以空间样本 image[y, x] 对应 ,频谱元素 spectrum[v, u] 对应 。NumPy 的 fft2 默认在最后两个轴上做变换;OpenCV 的 dft 通常接收 float32 或 float64,可用双通道数组保存实部与虚部。[2]
import cv2
import numpy as np

gray = cv2.imread("input.png", cv2.IMREAD_GRAYSCALE)
if gray is None:
    raise FileNotFoundError("input.png")

source = gray.astype(np.float32)
spectrum = cv2.dft(source, flags=cv2.DFT_COMPLEX_OUTPUT)
shifted = np.fft.fftshift(spectrum, axes=(0, 1))

magnitude = cv2.magnitude(shifted[:, :, 0], shifted[:, :, 1])
display_spectrum = np.log1p(magnitude)
display_spectrum = cv2.normalize(
    display_spectrum,
    None,
    0,
    255,
    cv2.NORM_MINMAX,
).astype(np.uint8)

unshifted = np.fft.ifftshift(shifted, axes=(0, 1))
restored = cv2.idft(
    unshifted,
    flags=cv2.DFT_SCALE | cv2.DFT_REAL_OUTPUT,
)
原始 DFT 的直流分量位于数组左上角。fftshift 只是循环重排象限,把零频移动到中心,便于观察低频到高频的径向分布;逆变换前必须用 ifftshift 撤销。log1p 只压缩显示动态范围,不能替换等待逆变换的原复数频谱。
3. 二维离散傅里叶变换的性质
二维 DFT 首先是线性变换:。这让不同滤波响应可以在频域相加组合。更重要的性质如下。
平移只改变相位。若图像循环平移 :
则
乘上的复指数模为 1,所以幅度谱完全不变。物体移动后幅度谱看似相同,并不代表图像内容的位置没有改变;位置信息进入了相位。反过来,只保留幅度而丢掉相位会失去位置关系,这正是后面频域滤波讨论相角作用的根据。
连续二维变换具有旋转对应性:空间图像旋转角度 ,频谱也旋转相同角度。离散数组的旋转需要插值和有限边界裁剪,因此实际 DFT 只能近似体现这一性质,并可能出现插值伪影。
二维 DFT 在两个方向都周期延拓:
实值图像还具有共轭对称性
因此其幅度谱中心对称,相位则反对称。这个性质可以检查实现是否正确,也能在实数 FFT 中减少冗余存储。
幅度谱与相位谱的作用并不对等。幅度描述每个空间频率的权重,相位规定这些平面波在何处对齐。自然图像重建时,相位往往对轮廓位置尤其关键;把相位置零而只保留幅度,通常不能恢复原结构。
同为 的周期数组 、 的二维循环卷积
满足
与连续卷积不同,模运算会把越过右边界的部分折回左边界、越过下边界的部分折回上边界。直接把两个原尺寸 DFT 相乘,得到的是循环卷积,不是通常空间滤波所需的线性卷积。这种首尾绕回并叠加到错误位置的现象称为交叠错误或环绕误差。
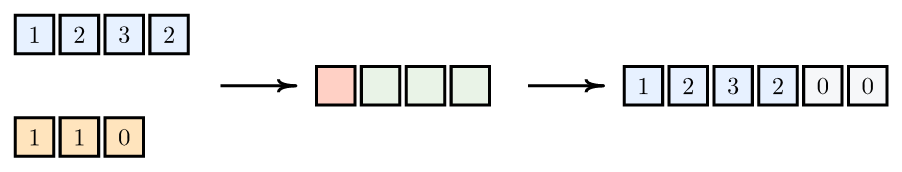
若输入大小为 ,核大小为 ,完整线性卷积大小为
因此两者都至少零填充到这个尺寸,再进行 DFT、逐点相乘和 IDFT,循环卷积在该尺寸内就与完整线性卷积一致。若只需要与原图同尺寸的结果,再按核锚点和边界约定裁剪;裁剪位置不正确会造成整体平移。
def fft_convolve2d(image: np.ndarray, kernel: np.ndarray) -> np.ndarray:
    image = np.asarray(image, dtype=np.float64)
    kernel = np.asarray(kernel, dtype=np.float64)

    out_rows = image.shape[0] + kernel.shape[0] - 1
    out_cols = image.shape[1] + kernel.shape[1] - 1

    image_spectrum = np.fft.fft2(image, s=(out_rows, out_cols))
    kernel_spectrum = np.fft.fft2(kernel, s=(out_rows, out_cols))
    full = np.fft.ifft2(image_spectrum * kernel_spectrum)
    return np.real_if_close(full).real

kernel = np.ones((9, 9), dtype=np.float64) / 81.0
full = fft_convolve2d(gray, kernel)

top = kernel.shape[0] // 2
left = kernel.shape[1] // 2
same = full[top:top + gray.shape[0], left:left + gray.shape[1]]
零填充并不是向原图增加真实黑边,它只是为线性卷积的完整输出预留不发生模回绕的索引范围。若希望模拟镜像或复制边界,应先按所需边界规则扩展图像,再做零填充和频域卷积。
三、快速傅里叶变换(FFT)
FFT 不是另一种变换,而是一族精确计算 DFT 的快速算法。朴素一维 DFT 需要 次量级的复乘加;二维 DFT 若直接按四重循环计算,需要 。FFT 利用单位根的周期性与对称性复用中间结果,把一维复杂度降为 。
1. 二维 DFT 的可分离性
二维指数可以分解:
所以先固定 ,沿水平方向对每一行做长度 的一维 DFT;再固定 ,沿垂直方向对每一列做长度 的一维 DFT,结果就是二维 DFT。运算次序也可以交换。
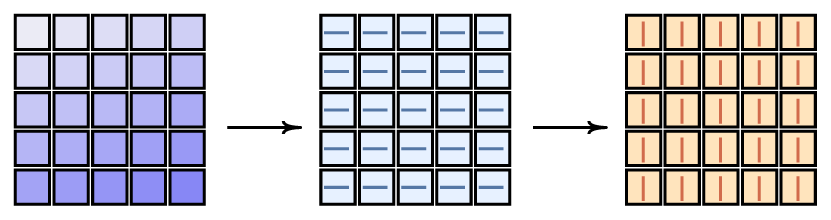
若一维使用朴素 DFT,逐行成本为 ,逐列成本为 ,仍比四重循环好;若两个方向都用 FFT,则成本约为
这也是 fft2 通常沿各轴反复调用一维 FFT,而不直接实现一个不可分的二维算法的原因。
def dft2_separable(image: np.ndarray) -> np.ndarray:
    image = np.asarray(image, dtype=np.complex128)
    after_rows = np.empty_like(image)

    for row in range(image.shape[0]):
        after_rows[row, :] = dft_naive(image[row, :])

    result = np.empty_like(after_rows)
    for col in range(image.shape[1]):
        result[:, col] = dft_naive(after_rows[:, col])
    return result
这段代码用于验证可分离性,不适合大图像;将 dft_naive 换成后文 FFT,即得到高效二维实现的基本结构。
2. 使用 DFT 计算 IDFT
比较 DFT 与 IDFT 的定义可见,二者指数符号相反,IDFT 还多出 。复共轭能改变指数符号,所以
这条恒等式意味着只需实现一个正向 DFT 核心,就能通过“输入共轭—正变换—输出共轭—缩放”得到逆变换。二维情形只把缩放改为 。
3. 快速傅里叶变换的算法实现
先考虑 。把 DFT 求和中的偶数下标与奇数下标分开:
因为 ,两段求和恰好是偶数子序列与奇数子序列的 点 DFT。记它们为 与 ,则
又因为 、 以 为周期,且 ,后半频率无需重新求和:
这就是逐次加倍法:先求长度 1 的 DFT,再合成长度 2、4、8,直到长度 。每层处理 个数据,共有 层,因此时间复杂度为 。
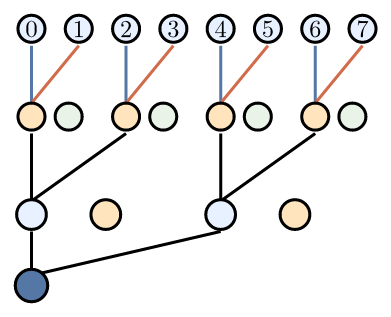
下面先按数学递归直接实现。它没有显式蝶形网络,便于把代码与公式逐句对应。
def fft_radix2_recursive(x: np.ndarray) -> np.ndarray:
    x = np.asarray(x, dtype=np.complex128)
    n = x.size

    if n == 1:
        return x.copy()
    if n == 0 or n & (n - 1):
        raise ValueError("length must be a positive power of two")

    even = fft_radix2_recursive(x[0::2])
    odd = fft_radix2_recursive(x[1::2])

    k = np.arange(n // 2)
    twiddle = np.exp(-2j * np.pi * k / n)
    weighted_odd = twiddle * odd

    result = np.empty(n, dtype=np.complex128)
    result[:n // 2] = even + weighted_odd
    result[n // 2:] = even - weighted_odd
    return result
递归终点 n == 1 对应单元素 DFT;切片 x[0::2]、x[1::2] 对应偶、奇子序列;同一个 weighted_odd 同时用于和与差,所以后半输出没有额外 DFT。可用随机复数组验证误差:
rng = np.random.default_rng(7)
x = rng.normal(size=1024) + 1j * rng.normal(size=1024)
expected = np.fft.fft(x)
actual = fft_radix2_recursive(x)

print(np.max(np.abs(expected - actual)))
4. 蝶形算子
递归实现已经达到 的算术复杂度,却不一定具有良好的实际性能。每层的步长切片会产生或访问分散的偶、奇子数组,递归调用产生函数栈,合并时还会反复分配 even、odd、weighted_odd 和 result。大数组下,内存分配、复制与缓存未命中可能比复乘加本身更昂贵。
给定同一子变换中的两个值 、 和旋转因子 ,蝶形同时计算
蝶形并没有改变上一节的数学公式,它改变的是数据组织。要理解迭代实现为什么需要位反转,必须先区分“二进制位的书写顺序”和“递归拆分读取这些位的顺序”。设 ,索引 的 位二进制展开为
其中最右侧的 是最低位,决定 的奇偶性。所谓 位反转置换,就是将位串的书写次序完全颠倒:
以 为例,索引 1 的三位表示为
反转时不是把十进制数字 1 倒写,而是把固定宽度三位串中的最低位移到最高位:
因此 001 反转为 100,索引 1 的数据被放到位置 4。固定为三位非常重要;若把 001 简写成 1 再“反转字符”,前导零会丢失,便不再是在 的索引集合上做置换。八个索引的完整对应为
这个置换来自基二时间抽取 FFT 的递归顺序。第一次按偶数项与奇数项拆分,检查的是最低位 ;第二次在各子序列中继续拆分,检查 ;第 次才检查最高位 。所以递归树从根到叶依次读到的路径是 ,恰好与通常从最高位到最低位书写索引的顺序相反。先按这个反转后的顺序摆放数据,递归树底层需要配对的元素就会落入相邻位置;随后迭代程序才能连续完成长度 2、4、8 的蝶形合并,而不必真的建立递归调用。
对任意 ,都有
reversed_index > index 时交换一次,便能避免同一对元素被交换两次。000、010、101 和 111 不需要移动,其余索引两两成对。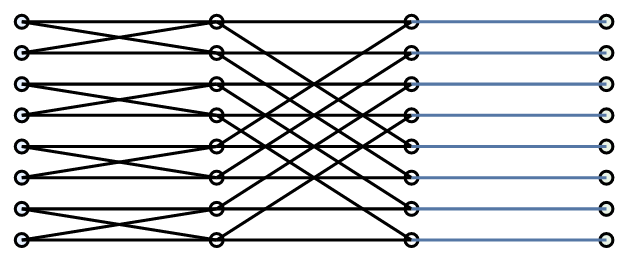
原地更新时必须先保存旧的 和 ,再写回两个位置;若先覆盖 后又用新值计算 ,结果会错误。一个清晰的迭代实现如下。
def reverse_bits(value: int, width: int) -> int:
    result = 0
    for _ in range(width):
        result = (result << 1) | (value & 1)
        value >>= 1
    return result

def fft_radix2_inplace(x: np.ndarray) -> np.ndarray:
    data = np.asarray(x, dtype=np.complex128).copy()
    n = data.size
    if n == 0 or n & (n - 1):
        raise ValueError("length must be a positive power of two")

    bits = n.bit_length() - 1
    for index in range(n):
        reversed_index = reverse_bits(index, bits)
        if reversed_index > index:
            data[index], data[reversed_index] = (
                data[reversed_index],
                data[index],
            )

    block = 2
    while block <= n:
        half = block // 2
        primitive = np.exp(-2j * np.pi / block)

        for start in range(0, n, block):
            twiddle = 1.0 + 0.0j
            for offset in range(half):
                left = start + offset
                right = left + half
                a = data[left]
                wb = twiddle * data[right]
                data[left] = a + wb
                data[right] = a - wb
                twiddle *= primitive
        block *= 2
    return data
这一版本只保留输入副本和少量标量,附加空间为 ;循环按连续块访问数据,更利于缓存。实际高性能库还会预计算或分块生成旋转因子、向量化多个蝶形、选择适合处理器缓存和 SIMD 宽度的基数,并对多线程做调度,因此手写 Python 版本用于理解,不会超过高度优化的 numpy.fft 或 OpenCV 实现。
5. 混合基算法与 Bluestein 算法
基二逐次加倍要求 。面对长度 12、15 或素数 17,简单递归会在某一层无法继续对半拆分。解决方法不是把所有数据盲目补到下一个二次幂;补零会改变采样频率网格,虽然在卷积中有明确用途,却未必是所需的原长度 DFT。
混合基 Cooley–Tukey 算法利用 的因数分解。令
代入 后,指数可以拆成长度 与长度 的子变换以及连接二者的旋转因子。于是长度 12 可按 分解,长度 30 可按 分解。每一层不必都使用相同基数,算法会依据长度因数、缓存和硬件选择 2、3、4、5 等基数。
若 是大素数,混合基仍无小因数可拆。Bluestein 算法利用恒等式
把 DFT 核改写为
对固定 求和时,第一项只依赖 ,第二项只依赖 ,第三项只依赖差 。因此原 DFT 被转换成两个“啁啾”序列的线性卷积,再用一个方便长度的 FFT 计算该卷积。卷积至少需要 个位置,通常补到不小于它且便于 FFT 的长度。
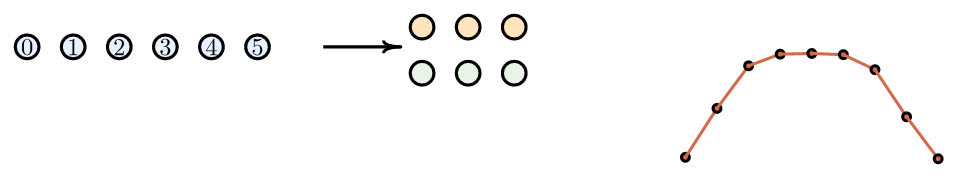
Bluestein 因而能处理任意正整数长度,其主要成本由卷积所用 FFT 决定,仍可达到 数量级。高性能 FFT 库通常综合使用混合基、专门的小基数代码、Bluestein 或其他素数算法;“FFT 只能处理二次幂”只适用于本章最先讲解的基二实现,不是 FFT 家族的普遍限制。
getOptimalDFTSize 可为卷积寻找便于快速变换的尺寸,但“计算更快的尺寸”和“避免交叠所需的最小尺寸”是两个条件,应同时满足。[2]References
- [1] R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed. Pearson, 2018.
- [2] OpenCV, “Discrete Fourier Transform.” Accessed: Aug. 26, 2026. [Online]. Available: https://docs.opencv.org/4.x/d8/d01/tutorial_discrete_fourier_transform.html
- [3] NumPy Developers, “Discrete Fourier Transform.” Accessed: Aug. 26, 2026. [Online]. Available: https://numpy.org/doc/stable/reference/routines.fft.html