高精度数与大数乘法
 Illustrated by
机器整数只有固定宽度,超过范围会溢出;任意精度整数(arbitrary-precision integer)把一个整数拆成若干“肢”并用动态数组保存。真正困难的不只是把数组变长,而是维护唯一表示、符号、进借位、临时空间和不同规模下的算法切换。本章只讨论整数。
一、高精度数的表示与存储
1. 基数与肢
选定整数基数 。任意非负整数 都可以写成
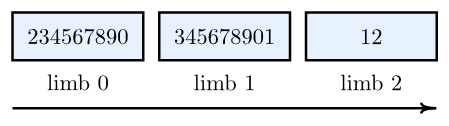
以 为例,十进制整数 12_345678901_234567890 被拆成
因此三个肢从低到高分别是 [234567890, 345678901, 12]。数组中一个元素代表 9 个十进制位;输出时最高肢直接打印,之后每个肢必须补足 9 位,否则中间的零会丢失。
为什么不令一个 u32 肢直接使用基数 ?这样加法和位运算最自然,但两个肢的乘积最多接近 ,还要再容纳已有结果肢与进位,所以通常需要 u128 中间类型。若选择 ,单个肢仍放在 u32 中,而乘积小于 ,连同进位也能安全放入 u64;十进制解析与格式化更直观。基数越大,肢数越少,但中间运算越容易溢出;基数选择本质上是在存储密度、机器指令和进制转换之间折衷。
2. 高位在前还是低位在前
高位在前与人类书写一致,比较和输出直观,但加减乘的进位从数组末端向前,扩展低位需要整体搬移。低位在前让最低肢位于下标 0,进位沿递增下标传播,追加最高肢只需 push,也方便按低半/高半切分 Karatsuba;代价是输出和大小比较要逆序遍历。任意精度库通常选择低位在前。
sign ∈ {-1, 0, 1},limbs 只保存幅值且按低位在前排列。规范表示要求最高端没有值为 0 的肢,并规定数学上的零唯一写成 sign = 0, limbs = [];非零值的符号只能为 -1 或 1。如果不规范化,同一个整数零可能写成 []、[0]、[0,0],甚至带负号;数值相等、大小比较、哈希与格式化便都必须处理多种别名。因而每个可能制造最高零肢的运算结束后都要执行 normalize,把内部不变量重新建立起来。
const BASE: u64 = 1_000_000_000;

#[derive(Clone, Debug, Eq, PartialEq)]
pub struct BigInteger {
    sign: i8,
    limbs: Vec<u32>,
}

impl BigInteger {
    pub fn zero() -> Self {
        Self {
            sign: 0,
            limbs: Vec::new(),
        }
    }

    pub fn from_i64(value: i64) -> Self {
        if value == 0 {
            return Self::zero();
        }

        let sign = if value < 0 { -1 } else { 1 };
        let mut magnitude = value.unsigned_abs();
        let mut limbs = Vec::new();
        while magnitude > 0 {
            limbs.push((magnitude % BASE) as u32);
            magnitude /= BASE;
        }
        Self { sign, limbs }
    }

    fn normalize(&mut self) {
        while self.limbs.last() == Some(&0) {
            self.limbs.pop();
        }
        if self.limbs.is_empty() {
            self.sign = 0;
        }
    }
}&BigInteger 并返回新值,内部再提供“写入给定缓冲区”的函数减少分配。先保证规范表示和别名安全,再做缓冲复用;快速乘法中临时数组的生命周期管理往往比公式更影响性能。二、高精度数的加减
1. 绝对值加法
低位在前使加法与纸笔竖式方向一致:下标从 0 递增,进位自然流向下一个数组元素。
- 结果至少需要
max(a.len(), b.len())个肢,并可能因最高进位再多一个。 - 第 步读取两数的第 肢;较短操作数越界时按 0 处理。
- 计算
sum = a[i] + b[i] + carry,写入sum % BASE,并令新进位为sum / BASE。 - 全部肢处理完后,若进位非零必须追加。遗漏这一步会把
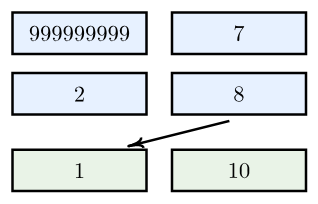
(BASE - 1) + 1错算成 0。
循环不变量是:处理第 肢前,out[0..i] 已等于结果对 取模,carry 恰好是尚待加入第 位的系数。每次迭代建立下一位,结束时就得到完整和。时间为 。
fn add_abs(a: &[u32], b: &[u32]) -> Vec<u32> {
    let n = a.len().max(b.len());
    let mut result = Vec::with_capacity(n + 1);
    let mut carry = 0_u64;

    for i in 0..n {
        let x = a.get(i).copied().unwrap_or(0) as u64;
        let y = b.get(i).copied().unwrap_or(0) as u64;
        let sum = x + y + carry;
        result.push((sum % BASE) as u32);
        carry = sum / BASE;
    }
    if carry != 0 {
        result.push(carry as u32);
    }
    result
}
2. 绝对值减法与符号
绝对值减法先要求 ,从而结果非负。第 位计算 a[i] - b[i] - borrow;若结果为负,就加一个 BASE 作为当前肢,并向下一肢借 1。与加法的无界进位不同,借位始终只可能是 0 或 1。循环结束时借位必须归零,否则调用者违反了大小前提。
带符号加法不能直接逐肢相加:同号时相加绝对值并保留符号;异号时先比较绝对值,用较大者减较小者,结果符号取绝对值较大的一方。若绝对值相等,结果必须规范化为唯一零。减法 a-b 可以通过翻转 b 的符号复用这套分派。
use std::cmp::Ordering;

fn cmp_abs(a: &[u32], b: &[u32]) -> Ordering {
    match a.len().cmp(&b.len()) {
        Ordering::Equal => a.iter().rev().cmp(b.iter().rev()),
        non_equal => non_equal,
    }
}

fn sub_abs(a: &[u32], b: &[u32]) -> Vec<u32> {
    debug_assert!(cmp_abs(a, b) != Ordering::Less);
    let mut result = Vec::with_capacity(a.len());
    let mut borrow = 0_i64;

    for i in 0..a.len() {
        let x = a[i] as i64;
        let y = b.get(i).copied().unwrap_or(0) as i64;
        let mut difference = x - y - borrow;
        if difference < 0 {
            difference += BASE as i64;
            borrow = 1;
        } else {
            borrow = 0;
        }
        result.push(difference as u32);
    }

    debug_assert_eq!(borrow, 0);
    while result.last() == Some(&0) {
        result.pop();
    }
    result
}
边界测试至少覆盖零、正负异号、连续跨多个零借位、最高肢产生进位、结果恰为零以及 i64::MIN;后者必须用 unsigned_abs,直接取负会溢出。
三、高精度数的乘法
1. 朴素乘法
朴素乘法又称学校乘法。它展开
具体过程如下:
- 若任一操作数为零,立即返回规范零;否则分配最多 个结果肢。
- 固定
a[i],从b[0]到b[n-1]执行一行竖式。位置i+j已可能含有前几行留下的数值,所以临时量必须包含result[i+j]、乘积和进位三部分。 - 当前槽写入临时量对
BASE的余数,商作为进位传向i+j+1。内层结束后还要写入该行的最终进位。 - 删除最高零肢并恢复符号;两个非零幅值的乘积符号等于两个符号之积。
若把所有 先累积到窄类型槽中,槽值会随肢数增长并最终溢出。下面每完成一次内层乘加就立即进位,使临时值始终受 量级约束。
fn schoolbook(a: &[u32], b: &[u32]) -> Vec<u32> {
    if a.is_empty() || b.is_empty() {
        return Vec::new();
    }

    let mut result = vec![0_u64; a.len() + b.len()];
    for (i, &x) in a.iter().enumerate() {
        let mut carry = 0_u64;
        for (j, &y) in b.iter().enumerate() {
            let position = i + j;
            let value = result[position] + x as u64 * y as u64 + carry;
            result[position] = value % BASE;
            carry = value / BASE;
        }
        result[i + b.len()] += carry;
    }

    while result.last() == Some(&0) {
        result.pop();
    }
    result.into_iter().map(|limb| limb as u32).collect()
}
若两数分别有 个肢,乘法次数恰为 ,故时间 、结果空间 。所谓低效是指规模翻倍时工作量约变为四倍;它并不表示小输入上一定慢。朴素法循环紧凑、内存连续且没有递归临时量,几十个肢以内往往仍优于快速算法,所以生产库一定设置切换阈值。
2. Karatsuba 乘法
把 、。普通分治需要四次半长乘法;Karatsuba 计算
再组合 。递推 ,故 。
a. 为什么只需要三次乘法
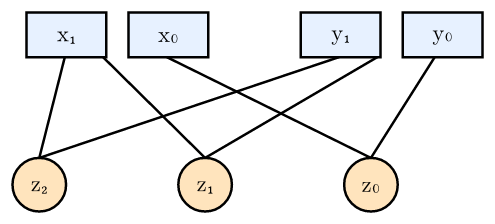
普通二分展开需要 四个半长乘法。Karatsuba 观察到组合时只需要两个交叉项之和,而
于是用三次递归乘法换取若干线性加减。乘法次数从四棵子树减到三棵子树,才是复杂度下降的来源;公式中的减法本身不会神奇地让单次乘法变快。
若两个 肢整数被近似等分,三次递归乘法处理规模 ,分割、加减与组合共需 ,则
b. 分割、递归与组合过程
- 长度不超过阈值时回到朴素法,避免递归、切片和临时分配的固定成本。
- 令
split = ceil(n / 2),把低split个肢视为 ,其余视为 ;长度不足的高半为空,数学上相当于 0。 - 递归求
z0与z2,再计算两半之和并递归求z1。 - 从
z1中减去z0与z2,得到交叉项;最后分别偏移 0、split、2*split个肢相加。
下面代码在“尚未执行基数进位”的有符号系数数组上运算。这样减法可以直接表达,组合结束后再统一进位;与只给出一个缺少辅助函数的伪实现相比,每个数据流向都能在代码中找到。
fn raw_schoolbook(a: &[i128], b: &[i128]) -> Vec<i128> {
    if a.is_empty() || b.is_empty() {
        return Vec::new();
    }
    let mut result = vec![0; a.len() + b.len()];
    for (i, &x) in a.iter().enumerate() {
        for (j, &y) in b.iter().enumerate() {
            result[i + j] += x * y;
        }
    }
    result
}

fn raw_add(a: &[i128], b: &[i128]) -> Vec<i128> {
    let mut result = vec![0; a.len().max(b.len())];
    for (i, slot) in result.iter_mut().enumerate() {
        *slot = a.get(i).copied().unwrap_or(0)
            + b.get(i).copied().unwrap_or(0);
    }
    result
}

fn raw_sub_assign(target: &mut Vec<i128>, value: &[i128]) {
    target.resize(target.len().max(value.len()), 0);
    for (slot, &x) in target.iter_mut().zip(value) {
        *slot -= x;
    }
}

fn add_shifted(target: &mut Vec<i128>, value: &[i128], shift: usize) {
    target.resize(target.len().max(value.len() + shift), 0);
    for (i, &x) in value.iter().enumerate() {
        target[i + shift] += x;
    }
}

fn karatsuba_coefficients(a: &[i128], b: &[i128]) -> Vec<i128> {
    let n = a.len().max(b.len());
    if n <= 32 {
        return raw_schoolbook(a, b);
    }

    let split = (n + 1) / 2;
    let (a0, a1) = a.split_at(a.len().min(split));
    let (b0, b1) = b.split_at(b.len().min(split));

    let z0 = karatsuba_coefficients(a0, b0);
    let z2 = karatsuba_coefficients(a1, b1);
    let sum_a = raw_add(a0, a1);
    let sum_b = raw_add(b0, b1);
    let mut z1 = karatsuba_coefficients(&sum_a, &sum_b);
    raw_sub_assign(&mut z1, &z0);
    raw_sub_assign(&mut z1, &z2);

    let mut result = Vec::new();
    add_shifted(&mut result, &z0, 0);
    add_shifted(&mut result, &z1, split);
    add_shifted(&mut result, &z2, 2 * split);
    result
}
这里返回的仍是卷积系数,而不是合法肢数组;调用者必须从低到高执行基数 的进位,再删除最高零肢。中间系数选用 i128,是因为 z1 -= z0 + z2 会经历有符号临时值。生产实现还会针对长度严重不等的输入选择其他分块方式,并通过预分配工作区复用 z0、z1、z2 的缓冲,否则渐近优势可能被内存分配抵消。
3. Toom-Cook 乘法
a. Toom-3 的五个阶段
把 写成 ,把 类似分成三块。乘积是四次多项式,共有五个系数,所以至少需要五个独立点值。常用点为 :
- 分块:选择 ,取得三段近似等长肢;
infinity点的值直接是最高系数 。 - 求值:用加减和小整数乘法计算 ,对 同理。
- 点乘:五对点值分别递归相乘;这是主要成本。
- 插值:由五个乘积值解出 。公式包含除以 2、3 等操作,但理论保证它们是整除;实现必须使用精确除法,不能引入浮点数。
- 重组:计算 ,再统一处理进位与符号。
Toom-3 的递推为 ,因此复杂度约为 。它比 Karatsuba 少做递归乘法,却增加更多求值、插值、负临时量和精确小除法;只有达到更大阈值后才占优。Toom-4、Toom-6 继续增加分块,指数进一步降低,但常数和实现复杂度也迅速增加。
4. Fast Fourier Transform (FFT) 乘法
a. 从系数域变到点值域
在系数表示中,一个输出系数需要许多乘加;在足够多的互异点上求值后,多项式乘法变成逐点乘法。FFT 利用单位根的对称性,在 时间内完成全部求值与逆求值:
- 把大基数肢继续拆成较小系数,避免卷积系数和舍入误差过大。
- 补零到 ,通常取方便基二 FFT 的二次幂。
- 对两组系数执行正向 FFT,得到频域点值数组。
- 对应位置复数相乘,再执行逆 FFT。
- 将接近整数的实部舍入,随后从低位到高位传播基数进位。
b. 误差为什么需要控制
复数 FFT 的旋转因子和每级蝶形运算都有浮点误差。系数过大、变换过长或舍入策略不当,最终值可能偏离正确整数超过 ,导致不可恢复的错误。因此实现会减小分块基数、使用误差界、分裂高低位或采用更高精度。算法是渐近快速的,但不是“把 f64 FFT 代码套上就自动精确”。
数论变换(NTT)在有限域中选择具有足够阶的单位根,所有运算都是精确模运算。单个模数的动态范围可能不足以容纳真实卷积系数,可用多个互素模数分别变换,再通过中国剩余定理重建。两条路线的主要复杂度均为 ,但硬件常数、可用长度与正确性论证不同。
5. Schönhage-Strassen 乘法
Schönhage–Strassen 不在普通复数上近似求值,而在模 的环中构造快速变换。选择这种模数的原因是乘以二的幂可通过循环移位和符号变化实现,适合把巨大整数分块后的卷积精确完成。
算法先把 位整数切成块,再选取足够长的变换长度;块序列在环上做类似 FFT 的变换、逐点相乘和逆变换,最后重建并传播进位。递归层次中的变换长度与模数规模相互配合,得到 的位复杂度。这里的 是二进制位数,而前面朴素法分析中的 常指肢数,比较公式时必须统一度量单位。
它消除了浮点舍入,却没有消除工程成本:环元素本身仍是大整数,变换需要复杂的分块、缓存调度与临时空间。只有操作数极大时,它才可能越过 Toom 或其他 FFT 路线的阈值。现代还有更快的理论算法,但主流库按实测阈值组成多级算法梯队,而不是仅实现渐近式最漂亮的一种。
四、主流语言中大数的实现方式
1. Java 与 Python:标准能力的一部分
Java 标准库 java.math.BigInteger 是不可变任意精度有符号整数。add、multiply 等方法返回新对象,因此不存在调用者可观察的原地修改;位运算公开表现为无限长二进制补码语义,但实现可以把符号与幅值分开存储。就 multiply 而言,实现按内部 mag 数组的 int 元素数分梯队:少于 KARATSUBA_THRESHOLD = 80 时用朴素乘法,80 起改用 Karatsuba,达到 TOOM_COOK_THRESHOLD = 240 后再走 Toom-Cook 三路算法(Toom-3)。阈值是当前实现特征而非语言保证,OpenJDK 已把两处值由早期的 50/75 调整为 80/240。[1], [2]
Python 的 int 本身就是任意精度整数,语法层面不区分机器小整数与大整数。数值增长越过内部范围后仍保持精确,但时间与空间当然会随位数增加;“不会溢出”不等于“运算成本仍为常数”。int 的乘法由 CPython 的 Objects/longobject.c 实现:两个操作数的内部 PyLong 数字都未超过 KARATSUBA_CUTOFF = 70 时用朴素乘法,否则进入 Karatsuba;int 乘法没有 Toom-Cook 或 FFT 路径。[3] 固定宽度二进制协议、哈希截断或与 C 接口交互时,仍必须显式检查范围和字节序。
2. Rust 与 C++:通过库选择语义
Rust 标准库只提供固定宽度整数,常用 num-bigint 的 BigUint 表示非负幅值,BigInt 表示有符号整数。运算符 trait 具有拥有值与借用值的多种实现;循环中写 &a * &b 可以避免为了传参克隆两个大操作数,但结果缓冲仍需分配。BigUint::mul 的底层 mac3 按肢数选算法:32 个 BigDigit 以内逐肢乘加(朴素乘法),超过 32 后改用 Karatsuba(Toom-2),超过 256 后进入 Toom-3;阈值由 cargo bench 基准调出,属于当前实现细节而非接口契约。解析、格式化和字节转换都通过明确方法完成。[4]
C++ 标准库同样没有统一任意精度整数。Boost.Multiprecision 提供与泛型数值代码较易结合的类型,GMP 则是常见的高性能底层库。二者的乘法梯队也不同:Boost 自研后端(如 cpp_int)只有朴素乘法与 Karatsuba,官方文档明确表示更高级的 Toom-Cook 与基于 FFT 的乘法尚未实现;GMP 则按机器调好的阈值依次启用朴素乘法、Karatsuba、更高阶 Toom-Cook,直至 Schönhage–Strassen 的 FFT 路径,操作数越大越依赖这一多级切换。[5], [6] 不同后端在异常、内存分配、表达式模板、线程与许可证方面有不同约束;选择“大数库”不仅是比较乘法复杂度,还要看整个项目的接口边界。
3. 通用大数与密码学大数不是同一需求
密码学还要求常数时间、固定宽度模运算和避免秘密相关分支,普通 BigInteger 的快速通用算法不自动满足这些侧信道要求。序列化也必须规定符号、字节序和最小编码,不能直接转储实现内部 limb。
通用大数为了平均性能会根据数值长度切换分支、跳过高零肢并使用不同乘法内核;这些行为可能泄露操作数长度或内容。密码学实现更关心固定执行路径、模约减、秘密清零与经过审计的底层指令。即便二者都在做“几百位整数乘法”,工程目标也完全不同。
| 规模 | 典型算法 | 复杂度 | 主要代价 |
|---|---|---|---|
| 小 | 朴素 | 最小常数 | |
| 中 | Karatsuba | 递归临时量 | |
| 较大 | Toom-Cook | 约 | 求值插值 |
| 巨大 | FFT/NTT | 变换与误差 | |
| 极巨大 | Schönhage–Strassen | 复杂环运算 |
Bibliography
- [1] Oracle, “BigInteger (Java SE 26).” [Online]. Available: https://docs.oracle.com/en/java/javase/26/docs/api/java.base/java/math/BigInteger.html
- [2] OpenJDK, “JDK-8022181: Tune algorithm crossover thresholds in BigInteger.” [Online]. Available: https://cr.openjdk.org/~bpb/8022181/webrev/src/share/classes/java/math/BigInteger.java.udiff.html
- [3] Python Software Foundation, “CPython Objects/longobject.c.” [Online]. Available: https://github.com/python/cpython/blob/main/Objects/longobject.c
- [4] The Rust Project Developers and Contributors, “The num-bigint Crate.” [Online]. Available: https://docs.rs/num-bigint/
- [5] Boost, “Boost.Multiprecision Performance Comparison.” [Online]. Available: https://www.boost.org/doc/libs/latest/libs/multiprecision/doc/html/boost_multiprecision/tut/perf.html
- [6] Free Software Foundation, “GNU MP Manual: Multiplication Algorithms.” [Online]. Available: https://gmplib.org/manual/Multiplication-Algorithms.html
- [7] A. Karatsuba and Y. Ofman, “Multiplication of Multidigit Numbers on Automata,” Soviet Physics Doklady, vol. 7, pp. 595–596, 1963.