哈希表
 Illustrated by
假设我们要根据学号查询学生信息。若把记录任意放进列表,查询一个学号就可能需要逐项比较,时间为 ;若按学号排序,可以二分到 ,却又要为维持顺序付出代价。更激进的想法是:能否直接从学号算出记录应当放在哪里?哈希表正是把键经过某个函数转换为槽位下标,使查询跳过与目标无关的大部分元素。
于是,哈希表常被概括为“平均 的查询、插入和删除”。然而这个结论附带许多条件:哈希值要足够均匀,冲突必须得到正确处理,表不能塞得过满,外部输入也不能轻易制造大量碰撞。哈希表并非“没有顺序的数组”,而是哈希函数、冲突策略、负载控制与内存布局共同组成的系统。本章将沿着这条依赖关系逐步展开。
HashMap<K, V> 保存从键到值的映射;HashSet<K> 只关心键是否存在,可以理解为值类型为单位类型 () 的 HashMap<K, ()>。因此只要理解键如何落位、比较和迁移,也就理解了集合的大部分实现。
一、哈希函数
哈希函数首先把任意键转换成一个固定宽度整数,再由表容量把整数约束到桶下标范围。若有 个桶,可把这个过程写成 。工程实现常把 取为二的幂,从而用位掩码替代取模,但这也意味着哈希值低位必须拥有良好分布。
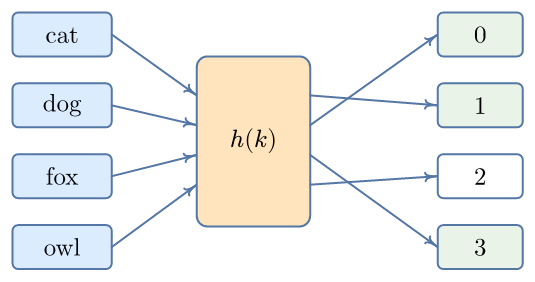
一个适用于哈希表的函数至少满足三项要求。第一,确定性:同一个键在同一张表中必须得到同一哈希结果。第二,一致性:若 k1 == k2,两者必须产生相同哈希值,否则查询会前往错误桶。第三,分布性:实际数据中的细小规律不应在桶下标中聚集。反过来,“哈希相同”绝不意味着“键相等”,因为有限宽度整数不可能无损表示无限或极大的键空间;哈希相同后仍须执行 Eq 比较。
fn index(hash: u64, capacity: usize) -> usize {
    debug_assert!(capacity.is_power_of_two());
    hash as usize & (capacity - 1)
}
当容量是二的幂时,低位质量尤其重要,因此实现常在选取桶之前进一步混合高低位。整数的简单取模、字符串的多项式滚动哈希适合讲解或受控数据,却未必适合直接处理不可信输入。密码学哈希强调难以寻找碰撞、原像与第二原像,通用哈希表则要求速度快、分布足够均匀并能抵御现实中的哈希洪泛;两者目标不同,不能因为某算法“是哈希”就随意互换。
Rust 的 Hash trait 不直接返回整数,而是把键的组成部分依次写入一个 Hasher。这使同一种键类型可以配合不同散列算法,也能通过 BuildHasher 为每张表创建带有随机种子的散列器。派生 #[derive(Hash, Eq, PartialEq)] 时,参与相等比较的字段与参与哈希的字段自然保持一致;手写实现则必须自己维护这个契约。
Eq + Hash,并须满足 k1 == k2 蕴含 hash(k1) == hash(k2)。键存入表后若通过内部可变性改变了影响相等性或哈希的字段,会破坏表的不变量;标准库把后果限制在该表内,但结果可能包括错误查询、泄漏或死循环。下面展示如何让自定义类型只按学号作为身份:
use std::hash::{Hash, Hasher};
struct Student { id: u64, name: String }
impl PartialEq for Student { fn eq(&self, o: &Self) -> bool { self.id == o.id } }
impl Eq for Student {}
impl Hash for Student { fn hash<H: Hasher>(&self, h: &mut H) { self.id.hash(h); } }
二、负载因子与扩容
即使哈希函数分布理想,当元素越来越多时,碰撞仍然必然增加。衡量表“拥挤程度”的量是负载因子(load factor),其中 为元素数、 为桶或可用槽位数。链地址法允许多个元素留在同一桶,所以 可以超过 ,但平均桶长会随之增长;开放地址法把所有元素放在固定槽位数组中,必须保留空槽作为查询终止标志,因而 必须小于 。
对开放地址法而言,负载因子与平均探测长度并非简单线性关系。当表接近填满时,即使只增加少量元素,也可能显著增长连续探测簇;失败查询尤其昂贵,因为它必须一直走到真正的空槽才能确认“不存在”。所以高性能实现会依据自身探测策略设置最大负载,而不是等到完全没有槽位才扩容。
capacity 不等于已分配字节,也不必等于内部桶数。公开 API 的容量通常表示“不扩容至少还能容纳多少元素”。若预知规模,应使用 with_capacity 或 reserve,避免多次重哈希。
三、哈希冲突的解决
冲突不可消除,因为键空间通常远大于槽位空间。即使采用理想随机哈希,随着元素数增加,至少一次碰撞的概率也会迅速上升;这与“生日悖论”具有相同结构。我们能做的不是假装冲突不会发生,而是让它少发生,并设计一种在冲突后仍能找回原键的确定规则。
1. 链地址法
链地址法(chaining)让每个桶保存一个元素集合,传统教材把这个集合画成链表。查询先计算桶下标,再在桶内逐个比较。实现常把完整哈希值与键一同保存:先比较整数哈希,只有相同才调用可能更昂贵的键相等比较。
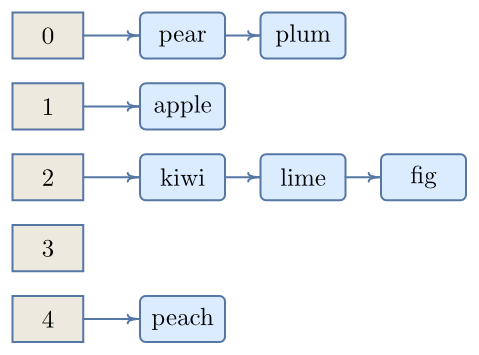
教学实现如下。为了让重点集中在冲突处理,桶内直接使用小 Vec;初始化和扩容可在后文所述规则上补齐:
use std::{collections::hash_map::DefaultHasher, hash::{Hash, Hasher}};

pub struct ChainMap<K, V> { buckets: Vec<Vec<(K, V)>>, len: usize }
impl<K: Eq + Hash, V> ChainMap<K, V> {
    fn bucket(&self, key: &K) -> usize {
        let mut h = DefaultHasher::new(); key.hash(&mut h);
        h.finish() as usize % self.buckets.len()
    }
    pub fn get(&self, key: &K) -> Option<&V> {
        self.buckets[self.bucket(key)].iter()
            .find(|(k, _)| k == key).map(|(_, v)| v)
    }
    pub fn insert(&mut self, key: K, value: V) -> Option<V> {
        let i = self.bucket(&key);
        if let Some((_, old)) = self.buckets[i].iter_mut().find(|(k, _)| k == &key) {
            return Some(std::mem::replace(old, value));
        }
        self.buckets[i].push((key, value)); self.len += 1; None
    }
}
桶内使用小 Vec 往往比真正的链表更快,因为正常负载下桶很短,连续存储避免了逐节点分配,也更有利于缓存。Java HashMap 选择了另一条工程折衷:普通桶使用链式节点,冲突严重且表容量足够时可以树化,利用比较顺序把病态桶内查询压到对数级。这说明“链地址法”只是大类,桶内部仍有大量布局选择。
2. 开放地址法
开放地址法(open addressing)不为每个冲突元素另外分配节点,而是把所有元素直接放进槽位数组。键的初始位置被占用后,按照预先规定的探测序列继续寻找。只要插入与查询使用相同序列,查询就能重走插入路径并找到目标。
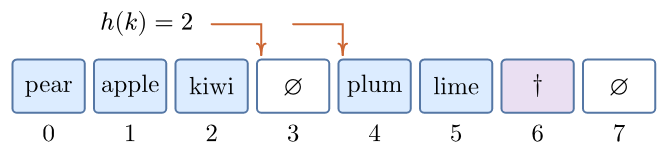
槽位至少有三种状态:从未占用、已占用、曾占用后删除。若删除时直接改成“从未占用”,原本跨过该位置的查询会误以为探测序列已经结束,从而漏掉后面的键。因此可以留下墓碑,或者使用后移删除,把同一探测簇中的后继元素适当前移。墓碑实现简单,却会逐渐拖长探测序列,所以表可能在元素数没有增加时也需要重哈希来清理墓碑。
a. 线性探测(linear probing)
。它连续访问内存、缓存友好,但容易形成“主聚集”:长连续簇吸收更多新元素。
b. 二次探测(quadratic probing)
。它减少主聚集,但容量和常数选择不当时不一定遍历所有槽位。现代高性能实现常以“组”为单位检查元数据,并采用等价于二次增长的探测策略。
c. 双重散列(double hashing)
。步长须与 互质才能覆盖整张表;若 为二的幂,可令第二哈希产生奇数步长。它减少同起点键之间的聚集,但要付出第二次散列成本。
enum Slot<K, V> { Empty, Tombstone, Full { hash: u64, key: K, value: V } }

fn find_slot<K: Eq, V>(slots: &[Slot<K, V>], hash: u64, key: &K)
    -> Result<usize, usize>
{
    let mask = slots.len() - 1;
    let mut first_tombstone = None;
    for step in 0..slots.len() {
        let i = (hash as usize + step) & mask;
        match &slots[i] {
            Slot::Empty => return Err(first_tombstone.unwrap_or(i)),
            Slot::Tombstone => first_tombstone.get_or_insert(i),
            Slot::Full { hash: h, key: k, .. } if *h == hash && k == key => return Ok(i),
            _ => {}
        };
    }
    Err(first_tombstone.expect("table must retain free space"))
}
返回 Ok(i) 表示找到旧键,Err(i) 表示可插入位置。这种返回类型把两个互斥结果编码进类型,调用者不必再做一次查询。
四、扩容策略
扩容通常在“下一次插入将越过负载阈值”时触发,容量按近似常数倍增长。不能简单在旧数组尾部补若干空槽,因为桶下标依赖容量:hash % 8 与 hash % 16 往往不同。所有元素必须依据新容量重新落位,这就是重哈希。
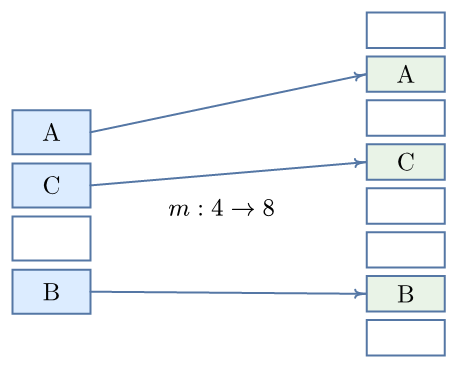
实现顺序应保证 panic 安全:先分配新表,把元素逐个移动过去,全部成功后再替换旧表。Rust 中移动 (K,V) 不要求 Clone,旧槽位可通过所有权迭代器或 mem::replace 取出。若散列器本身在哈希过程中 panic,库还要确保已经移动与尚未移动的元素都能被正确析构;这也是标准库实现远比课堂伪代码复杂的原因。
实时系统可能无法接受一次 停顿,可采用渐进式重哈希:同时保留新旧表,每次普通操作迁移少量桶,查询在迁移完成前检查两表。代价是状态机更复杂,迭代与并发同步也更难。
缩容要有滞回区间,例如在 时缩小、 时扩大,避免负载在单一阈值附近反复抖动。clear 是否释放容量也应由接口明确;Rust HashMap::clear 保留分配,shrink_to_fit 才请求缩容。
五、哈希攻击
“平均 ”不是最坏情况保证。若攻击者能构造许多落入同一桶或同一探测簇的键,单次操作会退化到 ,批量插入甚至达到 。Web 服务常把请求字段解析到哈希表中,攻击者只需发送特制键集合,就可能让 CPU 长时间耗在比较与探测上,这就是哈希洪泛拒绝服务。
防护不能只寄希望于“正常用户不会这样输入”,而应从算法、资源限制和监控三个层面共同进行:
- 每个进程或每张表使用随机种子,使攻击者难以离线预测碰撞;
- 使用带密钥、抗哈希洪泛的散列器处理不可信输入;
- 限制请求中的字段数、嵌套深度和总体字节数;
- 在冲突严重时改用平衡树,提供 上界;
- 监控探测长度或桶长度,把异常分布视为安全信号。
Rust 标准库 HashMap 的默认 RandomState 会随机播种;官方文档指出默认算法当前源自 SipHash 1-3,适合一般抗洪泛需求,但对短整数键并非最快。若替换为更快的自定义 BuildHasher,必须根据输入是否可信重新评估风险。
六、主流语言中哈希表的实现方式
| 语言 | 容器 | 冲突与布局 | 值得注意 |
|---|---|---|---|
| Rust | HashMap / HashSet | 二次探测与 SIMD 分组查找 | 默认随机播种;HashSet 基于 HashMap<K, ()> |
| Java | HashMap / HashSet | 桶结构,严重冲突时可树化 | 默认负载因子 0.75;允许一个 null 键 |
| C++ | unordered_map / unordered_set | 标准规定桶接口,不锁定具体布局 | 平均常数、最坏线性;哈希器可定制 |
Rust 当前实现来自 SwissTable 思路:控制字节与元素分离,一次比较一组元数据,再进入真正的键比较。这解释了为什么开放地址法在现代 CPU 上常胜过“每桶一条链”。[1] Java API 明确容量、负载因子和近似翻倍重哈希,并在可比较键的严重冲突中借助比较顺序。[2] C++ 标准只约束语义、桶接口与复杂度,不能把某个标准库版本的链表布局当成语言保证。[3]
实际使用时还应熟悉 Rust 的 entry API。朴素词频统计若先 get、再 insert,同一个键要执行两次哈希与探测;entry 把“已占用”和“空缺”作为枚举返回,使查找、插入或原地修改共享同一次定位结果:
use std::collections::{HashMap, HashSet};
let mut count = HashMap::new();
for word in ["to", "be", "or", "not", "to", "be"] {
    *count.entry(word).or_insert(0usize) += 1;
}
let unique: HashSet<_> = count.keys().copied().collect();
哈希表的平均复杂度很诱人,但它不提供排序、范围查询或稳定迭代顺序。需要有序遍历时选树,需要最小内存和批量搜索时也可能“排序向量 + 二分”更好。
Bibliography
- [1] The Rust Project Developers, “HashMap in std::collections.” [Online]. Available: https://doc.rust-lang.org/std/collections/struct.HashMap.html
- [2] Oracle, “HashMap (Java SE 25 and JDK 25).” [Online]. Available: https://docs.oracle.com/en/java/javase/25/docs/api/java.base/java/util/HashMap.html
- [3] ISO C++ Working Group, “Unordered Associative Containers: General Requirements.” [Online]. Available: https://eel.is/c++draft/unord.req.general