灰度变换
 Illustrated by
数字图像中的灰度值既决定整体明暗,也决定物体与背景能否分辨。原始图像若动态范围狭窄、暗部挤在少数灰度级,或成像设备的响应与观察需求不一致,就需要重新安排输入与输出灰度的对应关系。设输入灰度为 、输出灰度为 ,单像素变换统一写成
映射确定后,同一函数 独立作用于每个坐标,因此像素的位置和邻接关系都不改变,改变的是灰度的分布。这一点把本章方法分成两类:反相、对数、伽马与分段线性变换预先给定 ;直方图方法先统计整幅图或局部区域,再由统计结果构造映射。后者输出虽仍逐像素查表,映射本身却依赖其他像素,所以不能与预先固定的点运算混为一谈。区分二者的判据不在于“是否逐像素查表”,而在于查表是否与其余像素有关。[1]
若无特别说明,本章以 个灰度级的单通道图像为对象。8 位图像有 ,整数灰度属于 ;推导幂函数和对数函数时常先令 ,计算结束后再量化。这个归一化约定可以把公式与具体位深分开。
一、基本灰度变换
1. 图像反转与对数变换
设输入图像为 ,函数 把输入灰度域映射到输出灰度域。若
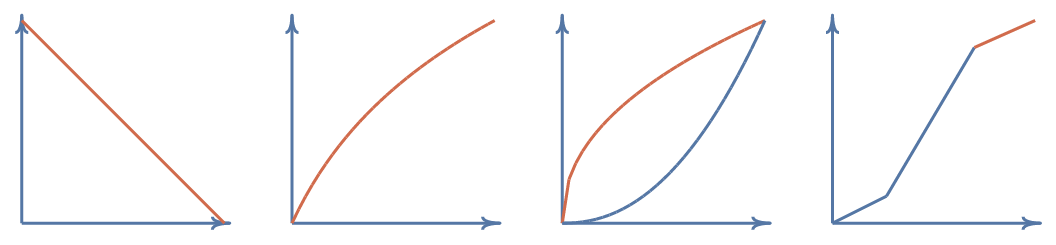
图像反转把灰度轴的两端互换:
黑色变白、白色变黑,中灰度围绕灰度轴中点对称。它适合观察暗背景上的浅色细节,例如某些底片、显微图像或文档图像;但它不是“提高对比度”的通用方法,因为任意两灰度间的距离并未改变。
对数变换写成
加 1 是为了让 时有定义。对数曲线在暗部斜率大、亮部斜率小,因此扩展低灰度差异、压缩高灰度动态范围。若输入归一化到 ,取 可使输出仍落在 ;若直接处理 ,取 。选择哪个常数取决于输入范围,而不是取决于“想提亮多少”。傅里叶频谱幅值常横跨多个数量级,显示时常用 log1p,但该显示变换不应覆盖待逆变换的原始频谱。
对 8 位图像,点变换只有 256 种输入。先建立长度为 256 的查找表,再用 cv2.LUT 一次映射全部像素,既能清楚表达公式,也避免在 Python 中逐像素循环。[2]
import cv2
import numpy as np

gray = cv2.imread("input.png", cv2.IMREAD_GRAYSCALE)
if gray is None:
    raise FileNotFoundError("input.png")

levels = np.arange(256, dtype=np.float32)
negative_lut = (255.0 - levels).astype(np.uint8)
log_lut = 255.0 * np.log1p(levels) / np.log(256.0)
log_lut = np.round(log_lut).astype(np.uint8)

negative = cv2.LUT(gray, negative_lut)
log_image = cv2.LUT(gray, log_lut)
2. 伽马变换
对归一化灰度 ,伽马变换定义为
当 时,曲线位于直线 上方,暗部被提升,图像整体趋亮;当 时,曲线位于直线下方,图像趋暗; 就是恒等映射。不能只凭“想变亮还是变暗”机械选择参数:若希望辨认暗区,应观察暗区是否因此拉开;同时也要检查亮区是否因压缩而损失层次。
成像设备、显示设备和文件编码可能已经包含非线性传递函数。因此,“对数组做一次 ”与严格的颜色管理不是一回事。若任务涉及物理光强、合成或定量测量,应先确认数据是否为线性光;本节只讨论作为图像增强工具的幂律映射。
def gamma_transform(gray: np.ndarray, gamma: float) -> np.ndarray:
    if gamma <= 0:
        raise ValueError("gamma must be positive")

    levels = np.arange(256, dtype=np.float32) / 255.0
    table = np.round(255.0 * np.power(levels, gamma))
    return cv2.LUT(gray, table.astype(np.uint8))

brighter = gamma_transform(gray, 0.55)
darker = gamma_transform(gray, 1.8)
3. 线性灰度变换
全局线性变换 能改变增益和偏置,但一次直线很难同时控制暗部、中间调和亮部。分段线性变换允许在若干控制点间使用不同斜率。最常用的对比度拉伸选择 与 :压缩两端区间,拉伸包含主要信息的中间区间。
灰度级分层则突出指定区间 。一种做法把区间内灰度设为高值、区间外设为低值,得到类似掩膜的结果;另一种只提升区间内像素、保留区间外原灰度,从而在突出目标的同时保留背景。两者目的不同,不能只用一个“切片”名称忽略输出规则。
def contrast_stretch(
    gray: np.ndarray,
    r1: int,
    s1: int,
    r2: int,
    s2: int,
) -> np.ndarray:
    if not (0 <= r1 < r2 <= 255):
        raise ValueError("require 0 <= r1 < r2 <= 255")

    x = np.arange(256, dtype=np.float32)
    xp = np.array([0, r1, r2, 255], dtype=np.float32)
    fp = np.array([0, s1, s2, 255], dtype=np.float32)
    table = np.interp(x, xp, fp)
    return cv2.LUT(gray, np.round(table).astype(np.uint8))

stretched = contrast_stretch(gray, 60, 20, 180, 235)

inside = (gray >= 90) & (gray <= 140)
sliced_binary = np.where(inside, 255, 0).astype(np.uint8)
sliced_preserve = gray.copy()
sliced_preserve[inside] = 255
4. 比特平面分层
比特平面分层不再把灰度视作不可分的整数,而是观察组成它的每一个二进制位。对 位无符号灰度,任一像素都能唯一写成
其中 。固定 后,由所有 组成的二值图像称为第 个比特平面; 是最低有效位, 是最高有效位。
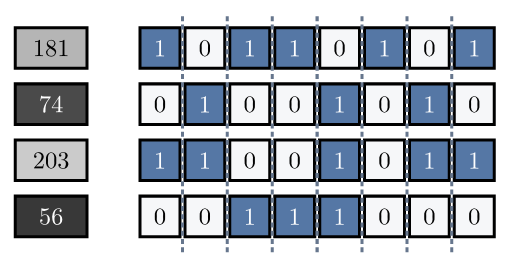
提取第 平面时,先把整数右移 位,再与 1 做按位与;在程序中即写成 (r >> k) & 1。 显示时把 0/1 乘 255 只是为了让二值平面肉眼可见,不能把这个显示数组误当作它对原灰度的数值贡献;真正贡献是 。
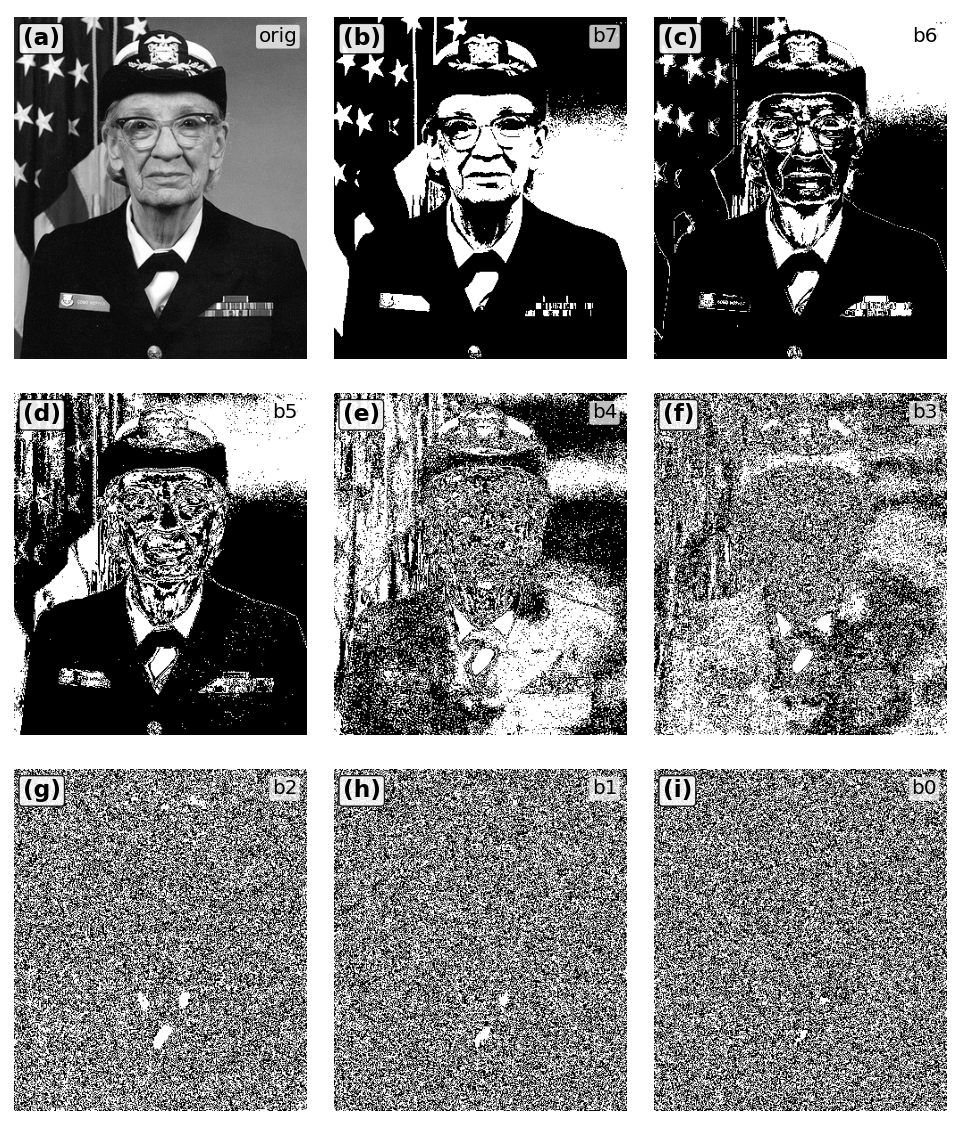
高位平面通常包含主体轮廓和大尺度明暗关系,因为改变高位会造成较大的灰度跳变;低位平面包含细小变化,也更容易混入量化噪声。不过“低位必然是噪声”并不成立:规则纹理、水印或精密测量信息也可能出现在低位。判断某一平面是否有用,应结合成像过程和任务,而不是仅凭位序。下面用一幅真实灰度照片的 8 个比特平面说明这种差异。
planes = []
for bit in range(8):
    plane01 = (gray >> bit) & 1
    planes.append((plane01 * 255).astype(np.uint8))

# 仅用第 7、6、5 位重建近似图像
keep_mask = np.uint8(0b11100000)
reconstructed = cv2.bitwise_and(gray, keep_mask)

# 等价的逐平面重建,使用 uint16 避免中间计算疑义
reconstructed2 = np.zeros_like(gray, dtype=np.uint16)
for bit in (5, 6, 7):
    plane01 = ((gray >> bit) & 1).astype(np.uint16)
    reconstructed2 += plane01 * (1 << bit)
reconstructed2 = reconstructed2.astype(np.uint8)若保留 位灰度图像的全部比特平面,并按权值 求和,则能够逐像素精确恢复原图;若丢弃最低的 位,重建误差满足
上界来自被丢弃部分的最大和 。因此只保留高位既是一种有损压缩,也是一种可明确估计误差的量化。
二、直方图
1. 计数、容器与归一化
设 图像具有 个灰度级。非归一化直方图是序列
其中 是灰度 在图像中出现的像素数。归一化直方图为
直方图容器是保存这些计数的数组。对 8 位灰度图,最直接的容器有 256 个箱,每个整数灰度对应一个箱。箱数少于灰度级数时,一个箱代表一段区间,只能得到粗粒度分布;浮点图像还必须显式规定统计范围。若把归一化到 的浮点图错误地按 [0, 256) 统计,绝大多数像素都会落进第一个箱。
hist_cv = cv2.calcHist(
    images=[gray],
    channels=[0],
    mask=None,
    histSize=[256],
    ranges=[0, 256],
)
hist_cv = hist_cv.ravel()

hist_np = np.bincount(gray.ravel(), minlength=256)
probability = hist_np.astype(np.float64) / gray.size

assert hist_np.sum() == gray.size
assert np.isclose(probability.sum(), 1.0)
直方图只记录每种灰度出现多少次,不记录它们出现在哪里。把一幅图像的像素任意打乱,直方图完全不变,视觉结构却会消失。因此直方图能描述全局亮暗分布,却不能单独描述形状、边缘和纹理。
2. 直方图均衡化
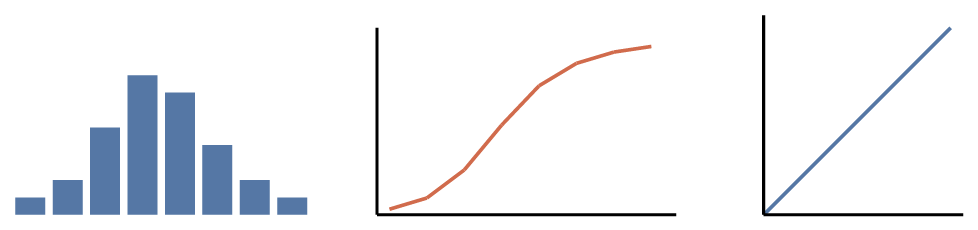
直方图均衡化不是简单地把最暗值拉到 0、最亮值拉到 。它还要利用各灰度出现的频率:像素聚集得越密的灰度区间,应当在输出轴上占据越宽的区间。这样才能把原先挤在一起的常见灰度拉开。
先看连续模型。令归一化输入灰度 具有概率密度 ,即 近似表示灰度落入长度为 的小区间的概率。定义累计分布函数
对一个确定的 ,积分累计的是所有“不亮于 ”的像素比例。因为密度非负, 增大时累计值不可能下降,所以 单调不减;又有 、,所以它把输入范围映射回单位区间。更重要的是, 的局部斜率恰好为 :输入像素越密集,曲线越陡,相邻输入灰度在输出端就被分得越开;输入像素稀少,曲线越平,相应区间就被压缩。
证明.由变量替换公式,。在 处,
连续结论给出设计方向,但数字图像只有有限样本和离散灰度,不能直接求连续积分。离散均衡化可以按以下次序得到。
- 统计每个灰度 的像素数 ,并除以总像素数 ,得到 。
- 从最低灰度开始累计概率,得到
- 将单位区间中的累计概率放大到输出灰度轴,并量化到整数:
- 对所有原值等于 的像素统一赋值 。由于 单调不减,这张查找表也单调不减,不会颠倒原有灰度次序。
例如,一幅只有 8 个灰度级的图像在 上分别有 个像素,其余灰度计数为 0。累计概率依次是 。取 后,四个实际出现的灰度约映射到
出现最频繁的 占了全图一半像素,累计曲线在这里跳得最大,但这四个像素仍必须映到同一个输出灰度。均衡化不能把相同输入灰度拆成多个输出灰度,因此离散输出不可能保证每个箱计数完全相同。
多个相邻输入灰度还可能因舍入落到同一输出灰度,原直方图中的空箱也没有像素可供分配。所以离散结果通常只是“累计分布尽量接近线性”,而不是得到完美平坦的直方图。这不是算法失效,而是有限样本与量化共同造成的限制。
def equalize_histogram(gray: np.ndarray) -> np.ndarray:
    if gray.dtype != np.uint8 or gray.ndim != 2:
        raise TypeError("expected an 8-bit grayscale image")

    hist = np.bincount(gray.ravel(), minlength=256)
    cdf = hist.cumsum()
    nonzero = np.flatnonzero(hist)
    if nonzero.size == 0:
        return gray.copy()

    cdf_min = cdf[nonzero[0]]
    denominator = gray.size - cdf_min
    if denominator == 0:
        return gray.copy()

    table = (cdf - cdf_min) * 255.0 / denominator
    table = np.clip(np.round(table), 0, 255).astype(np.uint8)
    return table[gray]

manual = equalize_histogram(gray)
opencv_result = cv2.equalizeHist(gray)
代码中的 hist 对应 ,cdf 对应尚未归一化的累计计数。减去首个非零累计值,是为了让实际出现的最低灰度映射到 0;再除以 gray.size - cdf_min,使实际最高灰度映射到 255。对常量图像,该分母为零,函数直接返回副本。最后的 table[gray] 不是逐像素搜索,而是把每个像素值当作查找表下标一次完成映射。
彩色图像不宜分别均衡 B、G、R 三个通道,因为三个不同映射会改变颜色比例;更稳妥的做法是转换到 YCrCb、Lab 等把亮度与色度分开的空间,只处理亮度通道后再转换回来。
3. 直方图规定化
均衡化由源图像自身决定映射,目标固定为近似均匀的灰度分布。如果希望医学图像采用某种便于观察的灰度比例,或者希望不同日期拍摄的图像接近同一亮度风格,“尽量均匀”就不是合适目标。直方图规定化,也称直方图匹配,允许直接给出目标直方图,或以一幅参考图像的直方图作为目标。
设源灰度累计分布为 ,目标灰度累计分布为 。连续情形下,规定化映射定义为
公式 不能只当作需要记忆的结论,它来自两个连续步骤。
- 对源灰度做均衡化,令
此时 表示源灰度 在源图中的累计百分位。例如 表示约 70% 的源像素不亮于 。
- 在目标分布中寻找具有相同累计百分位的灰度 ,要求
若 可逆,就有 。代入 ,最终得到 。
这实际上是在保持“百分位”而不是保持灰度数值:源图中处于第 70 百分位的灰度,被送到目标分布的第 70 百分位灰度。由此也能验证输出分布。对任意 ,映射后像素满足 ,等价于 ;而 在连续理想情形下均匀分布,所以该事件概率就是 。输出的累计分布因而正是目标累计分布。
数字图像中必须把上述两个积分改成累计和。完整过程如下。
- 分别统计源直方图 与目标直方图 。目标既可以是一组人为给定的计数,也可以来自参考图像;两幅图的像素总数不必相同,因为下一步会归一化。
- 计算两条归一化累计分布
这里 、 分别是源图和参考图的像素数。
- 对每个源灰度 ,在目标累计数组中寻找累计概率最接近 的位置:
然后令映射表 。
- 用同一映射表替换源图的所有像素,得到输出 。
例如某个源灰度的累计概率为 ,而目标累计数组在相邻两个灰度处分别为 0.48 和 0.70,那么应将它映射到累计概率 0.70 对应的灰度,因为 。这里比较的是累计概率,不是直接寻找计数相同的直方图箱,也不是把相同下标的灰度彼此对应。
目标累计分布是台阶函数:某些累计值可能跨过而不精确等于 ,平坦区还可能让多个灰度具有同一累计值,因此普通意义下的逆函数通常不存在。实际实现采用上述最近邻规则,相当于离散广义逆。由于 与 都单调不减,得到的匹配位置也应保持单调,较亮的源灰度不会被映到较暗的目标百分位。
def histogram_match(source: np.ndarray, reference: np.ndarray) -> np.ndarray:
    if source.dtype != np.uint8 or reference.dtype != np.uint8:
        raise TypeError("source and reference must be uint8")

    source_hist = np.bincount(source.ravel(), minlength=256)
    target_hist = np.bincount(reference.ravel(), minlength=256)
    source_cdf = np.cumsum(source_hist) / source.size
    target_cdf = np.cumsum(target_hist) / reference.size

    upper = np.searchsorted(target_cdf, source_cdf, side="left")
    upper = np.clip(upper, 0, 255)
    lower = np.maximum(upper - 1, 0)

    upper_error = np.abs(target_cdf[upper] - source_cdf)
    lower_error = np.abs(target_cdf[lower] - source_cdf)
    table = np.where(lower_error <= upper_error, lower, upper)
    return table[source].astype(np.uint8)

reference = cv2.imread("reference.png", cv2.IMREAD_GRAYSCALE)
matched = histogram_match(gray, reference)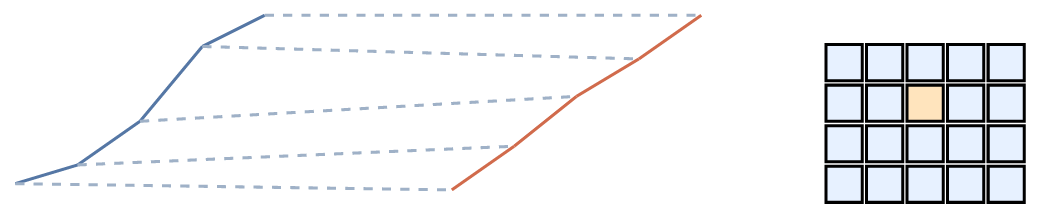
代码先用 searchsorted 找到第一个满足 的上侧候选 upper,再把它与前一个下侧候选 lower 比较,选择累计误差较小者。这正对应离散公式中的 ,而不是一个与推导无关的编程技巧。最后 table[source] 将源灰度统一替换为对应目标灰度。
匹配仍受离散性限制:源图像像素数、目标箱概率和单调映射共同决定可达到的近似程度。一个源灰度箱中的像素不能拆开送往多个目标箱,所以输出直方图只是尽量接近目标。它也只匹配一维灰度分布,不会把参考图中的物体、边缘和空间结构复制给源图。
4. 局部直方图处理
全局均衡化对整幅图只用一张映射表。如果图像左半边过暗、右半边过亮,两个区域的统计混在一起后,任何单一映射都可能顾此失彼。局部直方图处理改为在像素邻域或图像小块内估计分布,使增强随位置变化。
最直接的方法是对每个像素取一个滑动窗口,统计窗口直方图,并用窗口 CDF 映射中心像素。过程是:
- 以当前像素为中心确定局部窗口,并按边界规则补齐图像边缘。
- 统计窗口中 256 个灰度的计数,转为累计分布。
- 在累计分布中读取中心像素对应的值,缩放到输出范围。
- 移动窗口;高效实现会增量删除离开的列、加入新进入的列,而不是从头统计。
逐像素窗口计算昂贵,也容易在均匀区域把噪声过度拉伸。CLAHE 把图像分成小块,分别计算受限对比度的均衡映射:超过裁剪上限的直方图计数被截下并重新分配,从而限制局部斜率;随后对相邻小块的映射结果插值,减弱块边界。OpenCV 提供 createCLAHE 实现这一流程。[3]
clahe = cv2.createCLAHE(
    clipLimit=2.0,
    tileGridSize=(8, 8),
)
local_equalized = clahe.apply(gray)
tileGridSize 越大表示小块越多、统计区域越小,能够适应更局部的照明变化,但样本更少,也更容易放大噪声;clipLimit 控制允许的局部对比度增益。参数选择应同时观察目标细节、均匀背景噪声和块状伪影,而不能只追求直方图铺满整个范围。
References
- [1] R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed. Pearson, 2018.
- [2] OpenCV, “Operations on arrays: LUT.” Accessed: Aug. 26, 2026. [Online]. Available: https://docs.opencv.org/4.13.0/d2/de8/group__core__array.html
- [3] OpenCV, “Histograms.” Accessed: Aug. 26, 2026. [Online]. Available: https://docs.opencv.org/4.13.0/d6/dc7/group__imgproc__hist.html