图像分割
 Illustrated by
图像分割把像素域划分为具有任务意义的区域。它不是简单地让图像“看起来轮廓更明显”,而是输出边界、区域标签或前景掩膜,使同一区域内部满足某种一致性,不同区域之间存在足够差异。边缘检测从局部不连续性出发,阈值处理按灰度统计分类,区域生长从种子扩展同质区域,分水岭则把梯度图解释为地形并寻找集水盆地之间的分界。[1]
设图像定义域为 。分割是寻找非空子区域 ,满足
分割结果没有脱离任务的唯一“正确答案”。其关键在于谓词 : 规定了“区域内部怎样才算一致”,而一致与否本身取决于任务。同一张医学图像可以按器官、病灶或组织纹理分割;阈值、平滑尺度、邻接方式和标记都会改变结果。因此算法说明必须同时给出假设、参数和失败条件,不能只给一幅看似漂亮的输出。
一、边缘检测
1. 点与线的检测
孤立点和细线都是局部灰度不连续结构。检测方法是用零和核做相关:均匀区域的正负系数互相抵消,局部异常则产生大响应。孤立点常用
中心像素与八邻域差异越大, 越大。阈值过低会把噪声点全部检出,通常应先抑制噪声或要求响应同时满足局部极大条件。
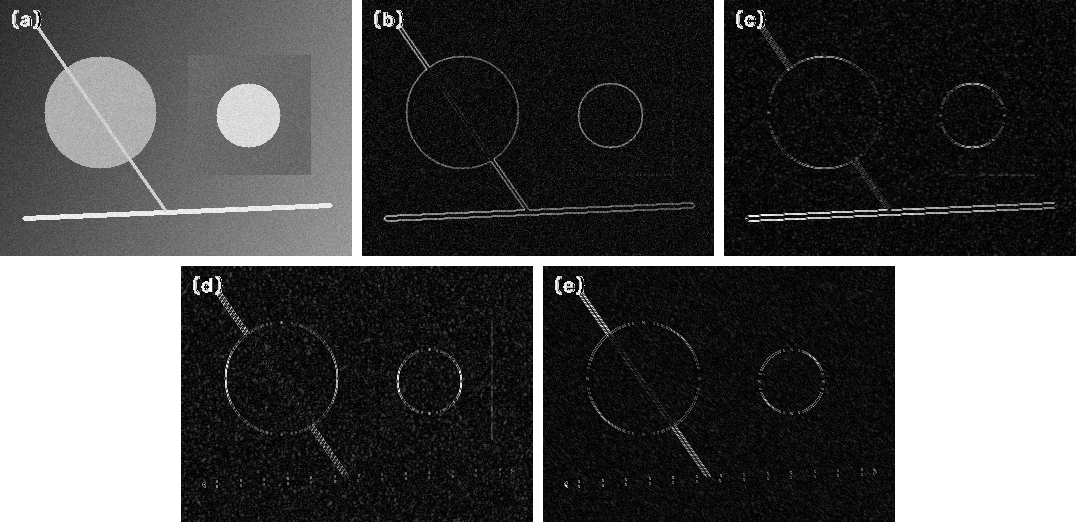
规定方向的线检测使用方向性核。例如水平、竖直、 和 的典型 核为
核中系数 2 所在方向与要检测的亮线方向一致。对每个像素计算四个绝对响应,最大者给出最可能的线方向;若目标是暗线,还要保留响应符号或同时检测反相核。
point_kernel = np.array(
    [[-1, -1, -1], [-1, 8, -1], [-1, -1, -1]],
    dtype=np.float32,
)
line_kernels = {
    "horizontal": np.array(
        [[-1, -1, -1], [2, 2, 2], [-1, -1, -1]],
        dtype=np.float32,
    ),
    "vertical": np.array(
        [[-1, 2, -1], [-1, 2, -1], [-1, 2, -1]],
        dtype=np.float32,
    ),
    "diagonal_45": np.array(
        [[-1, -1, 2], [-1, 2, -1], [2, -1, -1]],
        dtype=np.float32,
    ),
}

point_response = cv2.filter2D(gray, cv2.CV_32F, point_kernel)
line_responses = {
    name: cv2.filter2D(gray, cv2.CV_32F, kernel)
    for name, kernel in line_kernels.items()
}
best_direction = np.argmax(
    np.stack([np.abs(response) for response in line_responses.values()]),
    axis=0,
)
2. 边缘模型
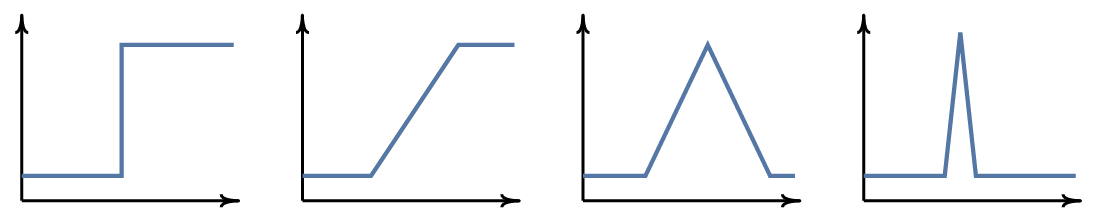
理想阶跃边缘在一个像素处突然改变灰度;真实镜头和采样会把它变成斜坡边缘。屋脊边缘先升后降,代表细线或窄脊;脉冲模型则描述更窄的孤立结构。不同模型的导数响应不同:阶跃的一阶导数产生单峰,屋脊产生一正一负响应,二阶导数在变化中心附近发生符号改变。
噪声包含大量高频变化,求导会把它放大。因此边缘检测必须在“抑制噪声”和“保持定位”之间选择尺度。平滑越强,虚假边缘越少,但相邻边缘可能合并,细小目标也可能消失。
3. 边缘检测
连续图像的一阶梯度为
幅值和方向为
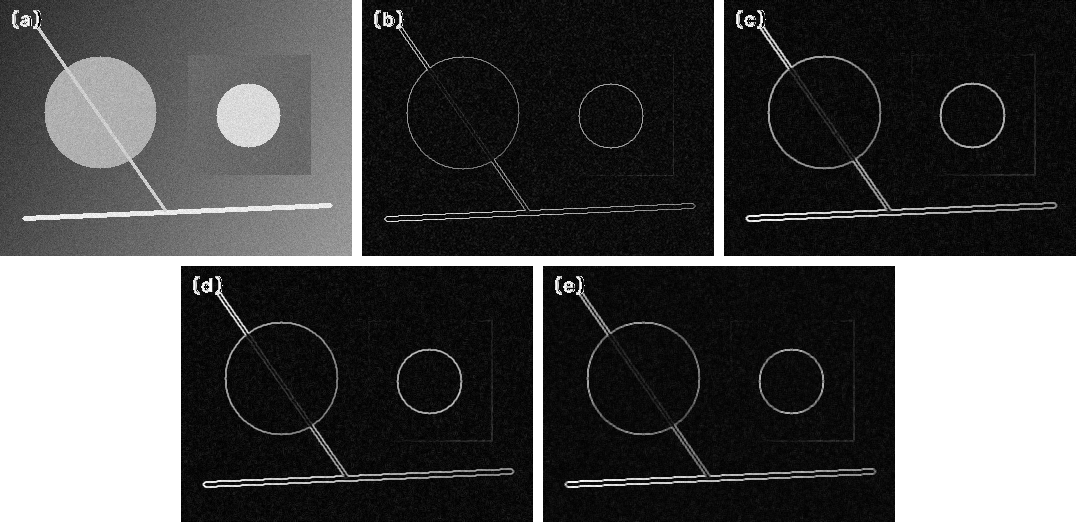
是灰度增长最快的法线方向,边缘切线方向与其相差 。离散核只能近似导数,不同算子在噪声抑制、旋转对称性和定位上有不同折中。
a. 一维核
最简单前向差分为 ,响应位于两个采样点之间;中心差分 使用两侧样本,尺度稍大且响应中心更对称。二维图像分别沿行、列应用差分得到 。使用 uint8 直接求导会丢失负响应,因此必须输出到有符号或浮点类型。
b. 罗伯特交叉梯度算子
Roberts 使用两个 对角差分核:
它计算量小、定位紧凑,但窗口太小,几乎没有平滑能力,对噪声敏感,方向也相对对角轴旋转。
c. Prewitt 算子
Prewitt 将一个方向的中心差分与正交方向的三点均值结合:
三行或三列累加提供轻微平滑,比 Roberts 稳定,但没有强调靠近中心的样本。
d. Sobel 算子
Sobel 把正交方向权重改为 :
它可分离为平滑向量与差分向量,中心权重改善了噪声下的梯度估计,是常用的一阶算子。OpenCV 的 Sobel 参数 dx=1,dy=0 计算 ,反之计算 。
e. Kirsch 罗盘核
Kirsch 用八个相隔 的罗盘核检测方向。北向核可写为
其余七个核由旋转得到。最终响应常取八个方向绝对值的最大值,并记录取得最大值的方向。较大的正负权重使响应强,但也更容易放大噪声。
gx = cv2.Sobel(gray, cv2.CV_32F, 1, 0, ksize=3)
gy = cv2.Sobel(gray, cv2.CV_32F, 0, 1, ksize=3)
magnitude = cv2.magnitude(gx, gy)
direction = np.arctan2(gy, gx)

# 只为显示才归一化;后续阈值应使用原浮点幅值。
display = cv2.normalize(magnitude, None, 0, 255, cv2.NORM_MINMAX)
display = display.astype(np.uint8)
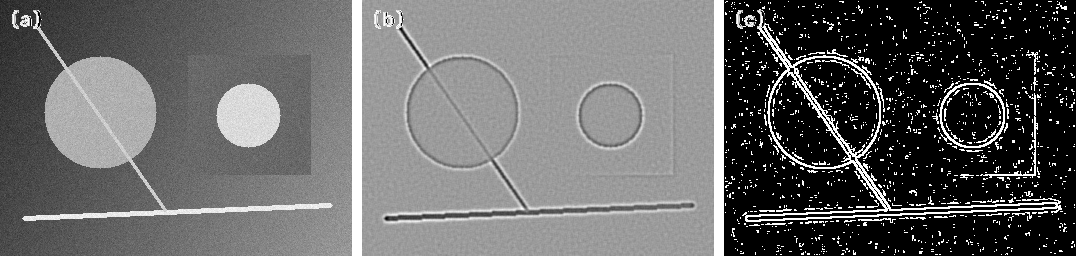
4. Marr–Hildreth 边缘检测子
Marr–Hildreth 先用高斯函数平滑,再对结果求拉普拉斯,最后检测二阶响应的过零点。卷积的结合律允许把两步合成高斯拉普拉斯核:
符号整体取反不会改变过零位置。 控制尺度:小 定位细节但敏感于噪声,大 只保留较粗结构。
只检查相邻像素符号不同会产生大量弱噪声边缘,还应要求过零两侧的响应差超过阈值。二维中通常检查水平、竖直和两条对角方向。LoG 的各向同性使其在连续边缘附近较易形成闭合响应,但这不是保证;噪声、边界缺口和阈值仍会使轮廓断裂。二阶导数还可能在宽斜坡两侧产生双边缘。
def marr_hildreth(
    gray: np.ndarray,
    sigma: float,
    crossing_threshold: float,
) -> tuple[np.ndarray, np.ndarray]:
    blurred = cv2.GaussianBlur(gray, (0, 0), sigma)
    response = cv2.Laplacian(blurred, cv2.CV_32F, ksize=3)
    edges = np.zeros(gray.shape, dtype=np.uint8)

    for y in range(1, gray.shape[0] - 1):
        for x in range(1, gray.shape[1] - 1):
            window = response[y - 1:y + 2, x - 1:x + 2]
            crosses_zero = window.min() < 0 < window.max()
            has_contrast = window.max() - window.min() >= crossing_threshold
            if crosses_zero and has_contrast:
                edges[y, x] = 255
    return response, edges
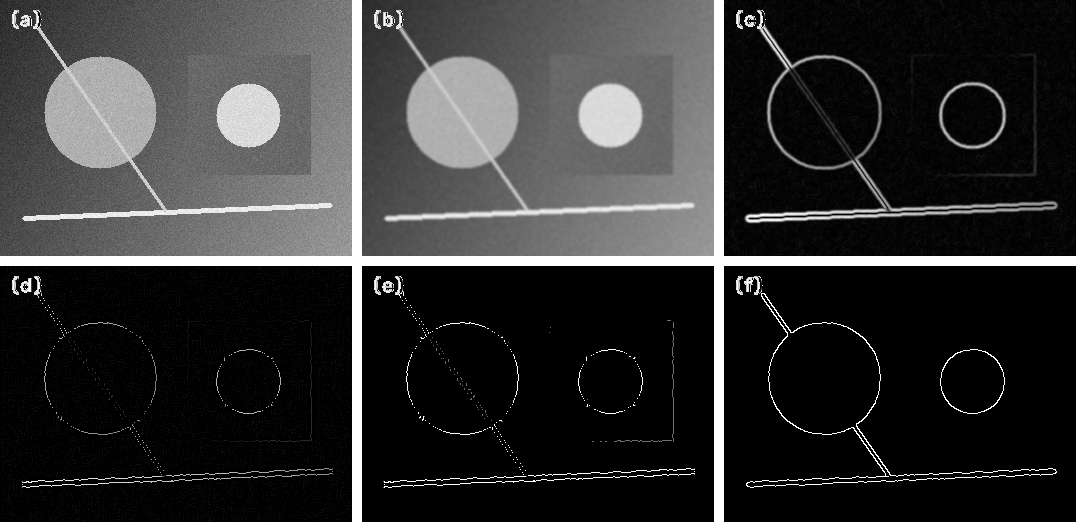
5. Canny 边缘检测子
Canny 的目标不是简单组合“高斯 + Sobel + 阈值”,而是在检测率、定位精度和单边缘单响应之间取得折中。完整过程包含五个互相依赖的步骤。
a. 高斯平滑
先用尺度 的高斯滤波抑制高频噪声。 决定检测尺度,核尺寸通常覆盖约 。若直接在噪声图上求梯度,后续非极大值抑制无法区分噪声峰和真实边缘峰。
b. 梯度幅值与方向
对平滑图计算 ,再求 和 。方向必须使用 atan2,否则无法区分象限且 时会除零。OpenCV 的 L2gradient=True 使用 ,否则可用较快的 近似。
c. 非极大值抑制
梯度峰通常有数个像素宽。对每个像素沿梯度方向比较前后两个插值幅值,只有局部最大值才保留。实现时可把方向量化为 四类,也可做线性插值提高定位。注意比较方向是梯度法线方向,不是边缘切线方向。
d. 双阈值分类
选择高阈值 与低阈值 ,且 。幅值不小于 的像素是强边缘,小于 的像素删除,中间像素是弱边缘候选。单一低阈值会保留噪声,单一高阈值会打断低对比边缘。
e. 滞后连接
从全部强边缘出发,沿八邻接递归吸收与强边缘连通的弱边缘;不与任何强边缘连通的弱响应删除。这一步利用边缘的空间连续性,使低对比段只有在属于可靠轮廓时才保留。
def canny_edges(
    gray: np.ndarray,
    sigma: float = 1.2,
    low_threshold: float = 40.0,
    high_threshold: float = 100.0,
) -> np.ndarray:
    if not 0 <= low_threshold < high_threshold:
        raise ValueError("thresholds must satisfy 0 <= low < high")

    blurred = cv2.GaussianBlur(gray, (0, 0), sigma)
    return cv2.Canny(
        blurred,
        threshold1=low_threshold,
        threshold2=high_threshold,
        apertureSize=3,
        L2gradient=True,
)二、全局阈值处理
给定单一阈值 ,二值输出为
全局阈值适用于目标与背景灰度分布相对分离、照明变化不强的图像。直方图若有两个峰,谷底附近阈值往往合理;但直方图只统计灰度数量,不包含像素位置,所以相同直方图可以对应完全不同的空间结构。
1. 基本全局阈值处理
若不知道阈值,可以迭代估计:
- 以图像均值或最小、最大灰度中点作为初值 。
- 用 把像素分为 与 。
- 分别计算两组均值 。
- 更新 。
- 当 时停止。
若某组为空,均值无定义,程序应停止或保留旧阈值。这个方法相当于一维两类聚类,但容易受类别面积极不均衡、离群值和重叠分布影响。
def iterative_global_threshold(
    gray: np.ndarray,
    tolerance: float = 0.5,
    maximum_iterations: int = 100,
) -> tuple[float, np.ndarray]:
    values = gray.astype(np.float64)
    threshold = 0.5 * (values.min() + values.max())

    for _ in range(maximum_iterations):
        high = values[values > threshold]
        low = values[values <= threshold]
        if high.size == 0 or low.size == 0:
            break
        updated = 0.5 * (high.mean() + low.mean())
        if abs(updated - threshold) < tolerance:
            threshold = updated
            break
        threshold = updated

    binary = np.where(values > threshold, 255, 0).astype(np.uint8)
    return threshold, binary
2. Otsu 方法
Otsu 方法不假定两个峰服从高斯分布,而是在所有候选阈值中选择类间方差最大的一个。这里的“最优”是针对单个统计量——把两类分离得最开——并不意味着结果在感知或任务上最优;若两个类在灰度上本来严重重叠,任何阈值都只能把分布切开,误差并不会因此消失。设灰度级为 ,直方图计数为 ,总像素数为 ,归一化概率为
对候选阈值 ,两类分别为 与 。类概率为
类均值为
全局均值为 。类间方差定义为
利用 ,还可写成
最佳阈值为使 最大的 。总方差满足 ,因此最大化类间方差等价于最小化类内方差。
对固定图像直方图,总方差 与阈值 无关,并且
证明.把每一类中的偏差分解为
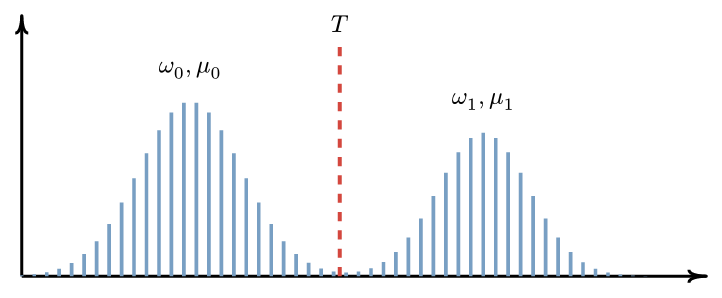
为了 扫描全部阈值,可预先计算累计概率 与累计一阶矩 ,不必为每个 重新求和。若某一类概率为零,该候选阈值跳过。
a. 多阈值扩展
若图像包含 个灰度类别,需要 个有序阈值
令 ,第 类区间为 ,其概率与均值为
多类类间方差为
选择使该式最大的阈值组合。三类时穷举 需要约 次组合;类别更多时组合数迅速增长,可用动态规划或专门的多 Otsu 实现。
def otsu_three_classes(gray: np.ndarray) -> tuple[int, int]:
    histogram = cv2.calcHist(
        [gray], [0], None, [256], [0, 256]
    ).ravel().astype(np.float64)
    probability = histogram / histogram.sum()
    omega = np.cumsum(probability)
    moment = np.cumsum(probability * np.arange(256))
    total_mean = moment[-1]

    best_score = -1.0
    best_thresholds = (0, 0)
    for first in range(1, 254):
        weight0 = omega[first]
        if weight0 <= 0:
            continue
        mean0 = moment[first] / weight0

        for second in range(first + 1, 255):
            weight1 = omega[second] - omega[first]
            weight2 = 1.0 - omega[second]
            if weight1 <= 0 or weight2 <= 0:
                continue
            mean1 = (moment[second] - moment[first]) / weight1
            mean2 = (total_mean - moment[second]) / weight2
            score = (
                weight0 * (mean0 - total_mean) ** 2
                + weight1 * (mean1 - total_mean) ** 2
                + weight2 * (mean2 - total_mean) ** 2
            )
            if score > best_score:
                best_score = score
                best_thresholds = (first, second)
    return best_thresholds
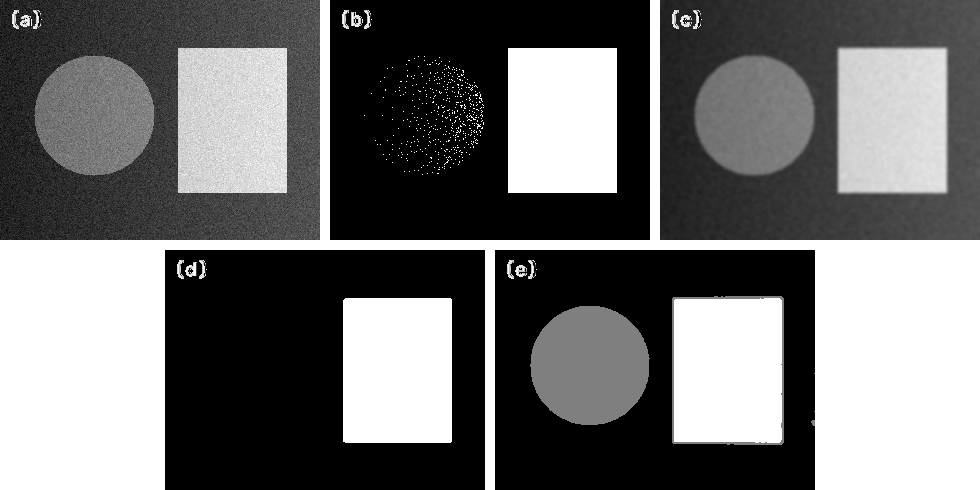
3. 阈值处理的改进
a. 使用图像平滑
噪声会让同一区域的直方图变宽并互相重叠。先用高斯或中值滤波缩小类内方差,再估计阈值,通常比对原噪声图直接阈值更稳定。但平滑也会混合边界两侧灰度,小目标可能被消除;核尺度应小于需要保留的最小结构。
b. 使用边缘
当大面积背景主导直方图时,可以先检测边缘,在边缘邻域中估计前景与背景的代表灰度或阈值。边缘带同时采到分界两侧,减少类别面积不平衡的影响。边缘本身若不可靠,估计也会偏差,因此通常先平滑,再用较宽的边缘带收集样本。
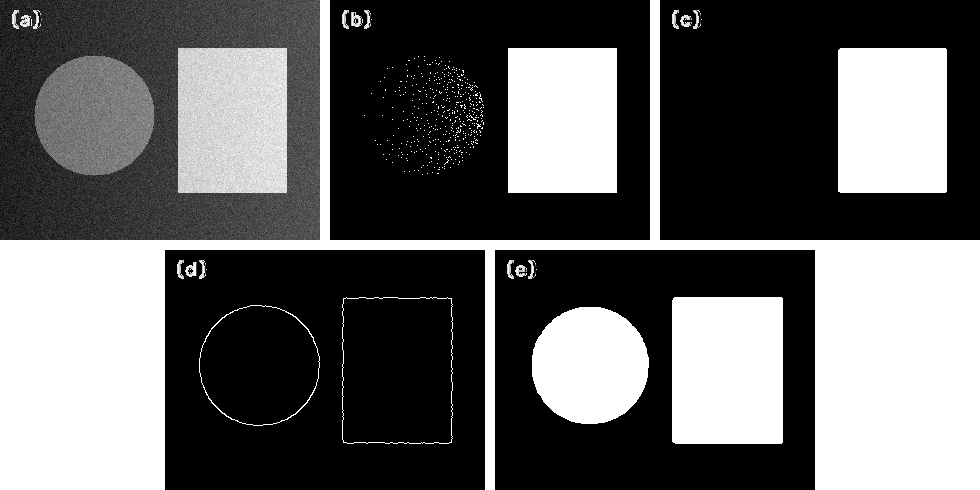
若照明变化造成同一物体在不同位置灰度差异大于物体与背景差异,任何单一全局阈值都会失败,此时应做背景校正、分块阈值或自适应阈值,而不是继续微调一个全局数字。
三、区域生长
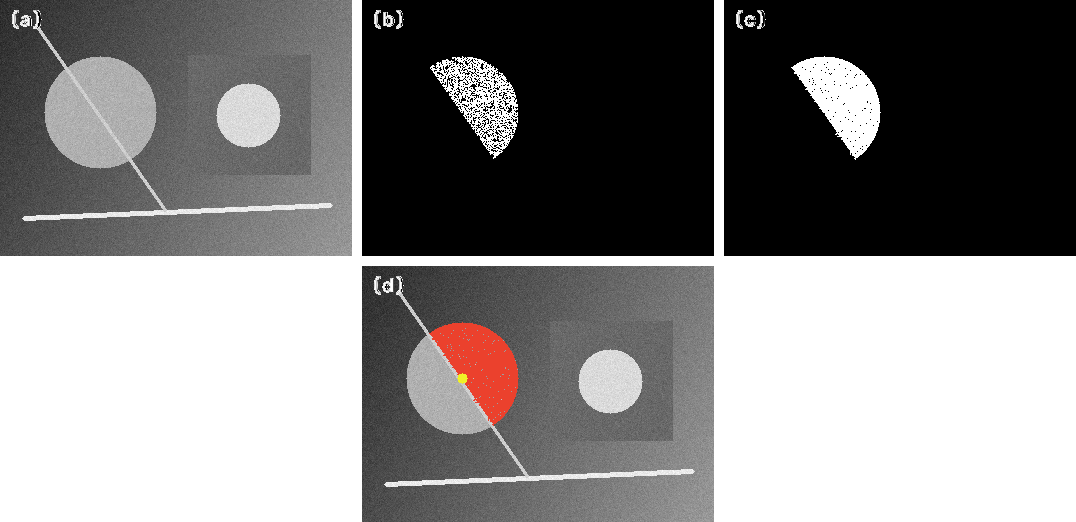
基本算法过程如下。
- 选择位于目标内部的种子,建立队列并标记已接受像素。
- 弹出一个区域像素,检查其四邻域或八邻域。
- 对尚未访问的邻居计算同质性条件,例如 。
- 满足条件的邻居加入区域和队列,并更新区域统计量。
- 队列为空时停止;对多个种子可分别生长,冲突时按距离或相似度决定标签。
若始终与固定种子灰度比较,结果不受生长顺序影响,但不能适应缓慢变化;若与动态区域均值比较,能跟随区域变化,却可能发生“泄漏”:均值逐步漂移后跨过弱边界。可同时限制局部梯度、最大路径代价或区域方差。
from collections import deque


def region_grow(
    gray: np.ndarray,
    seed: tuple[int, int],
    tolerance: float,
) -> np.ndarray:
    seed_y, seed_x = seed
    reference = float(gray[seed_y, seed_x])
    accepted = np.zeros(gray.shape, dtype=np.uint8)
    queue = deque([(seed_y, seed_x)])
    accepted[seed_y, seed_x] = 255

    while queue:
        y, x = queue.popleft()
        for delta_y, delta_x in ((-1, 0), (1, 0), (0, -1), (0, 1)):
            next_y = y + delta_y
            next_x = x + delta_x
            inside = (
                0 <= next_y < gray.shape[0]
                and 0 <= next_x < gray.shape[1]
            )
            if not inside or accepted[next_y, next_x] != 0:
                continue
            difference = abs(float(gray[next_y, next_x]) - reference)
            if difference <= tolerance:
                accepted[next_y, next_x] = 255
                queue.append((next_y, next_x))
    return accepted
四、分水岭分割算法
1. 基础
分水岭把标量图像解释为地形:低值是谷底,高值是山脊。分割通常不直接使用原灰度,而使用梯度幅值,使物体内部成为低洼盆地,真实边界成为高脊。每个局部极小值都可能形成集水盆地,所以噪声会产生大量极小值并导致严重过分割。
2. 水坝
想象从每个极小值处打孔并缓慢注水。水位上升时,各盆地的已淹没区域向外扩张;当两个不同来源的水体即将相遇,就在接触处修建水坝。水位升到最高后,水坝集合就是分水线。
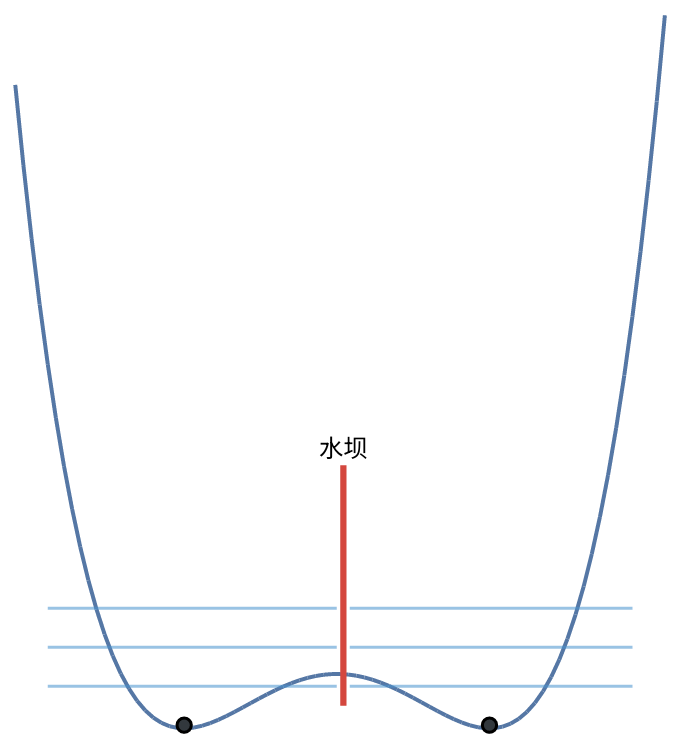
数字实现可按高度从低到高处理像素,使用优先队列维护淹没前沿。一个未标记像素若只邻接一个盆地标签,就继承该标签;若邻接多个不同标签,则标为分水线。平台区域需要统一处理,否则扫描顺序会影响边界位置。
3. 算法过程
不带标记的基本分水岭过程为:
- 计算平滑图像的梯度幅值 。
- 找出 的全部局部极小区域,分别赋予盆地标签。
- 按 从小到大扩张各标签,相当于逐级升高水位。
- 同一像素若被两个盆地同时到达,建立分水线。
- 处理到最大高度后输出盆地标签和分水线。
因为梯度中的每个噪声凹点都可能成为极小值,实际很少直接接受基本结果。平滑可以减少极小值,但过强平滑会移动边界;更可靠的方法是由先验知识提供标记。
4. 标记
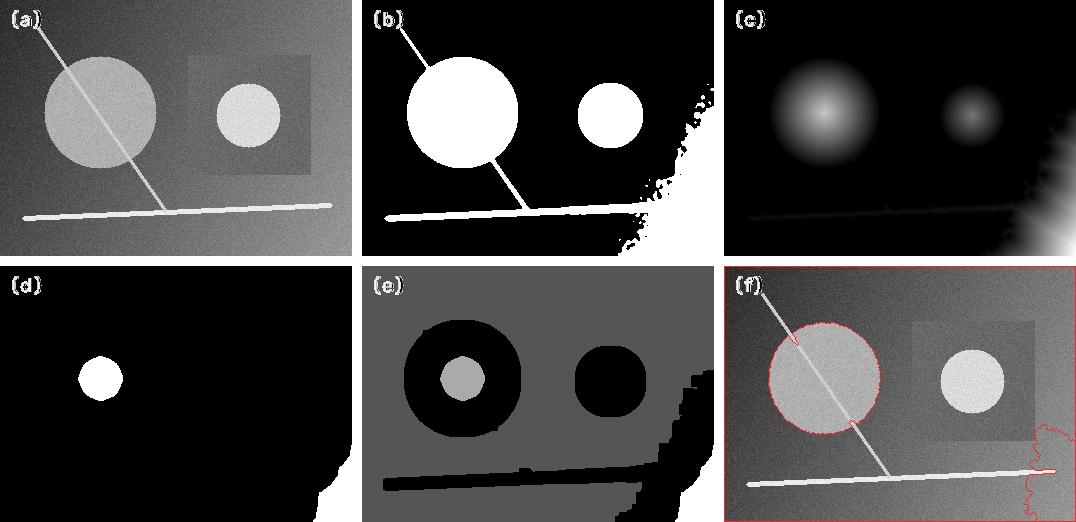
常见标记构造流程如下。
- 对二值前景做开运算,删除噪声,得到较可靠的目标区域。
- 膨胀得到确定背景
sure_bg。 - 对前景做距离变换;距离局部最大处远离边界,以高阈值得到确定前景
sure_fg。 sure_bg - sure_fg是未知边界带。- 对
sure_fg做连通分量标记,标签整体加 1,把确定背景保留为标签 1;未知带设为 0。 - 在原彩色图或梯度图上运行分水岭。OpenCV 以标签 表示最终分水线。
def marker_watershed(
    image_bgr: np.ndarray,
    binary: np.ndarray,
) -> tuple[np.ndarray, np.ndarray]:
    kernel = np.ones((3, 3), dtype=np.uint8)
    opened = cv2.morphologyEx(
        binary,
        cv2.MORPH_OPEN,
        kernel,
        iterations=2,
    )
    sure_background = cv2.dilate(opened, kernel, iterations=3)

    distance = cv2.distanceTransform(opened, cv2.DIST_L2, 5)
    _, sure_foreground = cv2.threshold(
        distance,
        0.48 * distance.max(),
        255,
        cv2.THRESH_BINARY,
    )
    sure_foreground = sure_foreground.astype(np.uint8)
    unknown = cv2.subtract(sure_background, sure_foreground)

    _, markers = cv2.connectedComponents(sure_foreground)
    markers = markers.astype(np.int32) + 1
    markers[unknown > 0] = 0

    markers = cv2.watershed(image_bgr.copy(), markers)
    overlay = image_bgr.copy()
    overlay[markers == -1] = (0, 0, 255)
return markers, overlaycv2.watershed 要求三通道输入图像与 int32 标记矩阵具有完全相同的行列尺寸。标记值 0 表示待确定区域,正整数表示已知盆地,运算后 表示边界。若前景标记彼此粘连,分水岭无法再把它们拆开;若一个目标内有多个标记,则会被过分割。References
- [1] R. C. Gonzalez and R. E. Woods, Digital Image Processing, 4th ed. Pearson, 2018.
- [2] J. Canny, “A Computational Approach to Edge Detection,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. PAMI-8, no. 6, pp. 679–698, 1986.
- [3] N. Otsu, “A Threshold Selection Method from Gray-Level Histograms,” IEEE Transactions on Systems, Man, and Cybernetics, vol. 9, no. 1, pp. 62–66, 1979.
- [4] OpenCV, “Image Segmentation with Watershed Algorithm.” Accessed: Aug. 28, 2026. [Online]. Available: https://docs.opencv.org/4.x/d3/db4/tutorial_py_watershed.html